
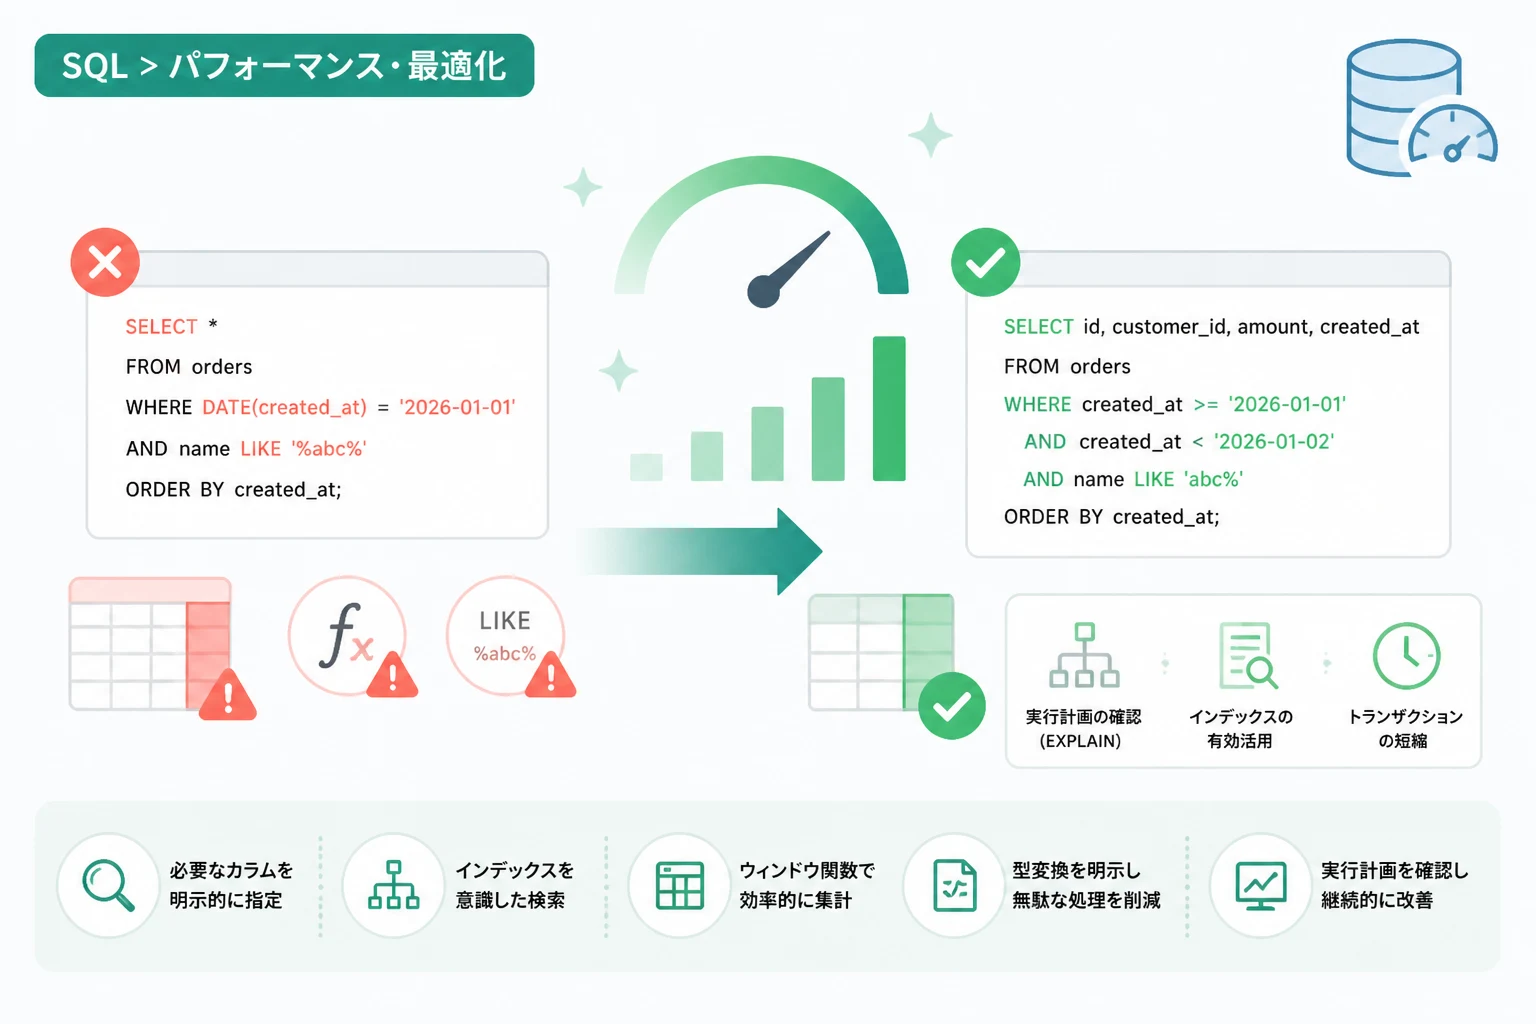
2026年現在、データドリブンな意思決定はあらゆる企業において当然のプロセスとなりました。
システム開発やデータ分析の現場で、SQLを扱う機会はかつてないほど増えています。
しかし、直感的に記述したクエリが、実はデータベースのパフォーマンスを著しく低下させているケースは少なくありません。
特にクラウドネイティブなデータベース環境では、非効率なクエリがそのままコスト増加に直結してしまいます。
本記事では、SQLを記述する際に避けるべき15の慣習と、それを改善するための具体的なテクニックを詳しく紹介します。
エンジニアとして一歩上のスキルを身につけるために、やってはいけないアンチパターンを正しく理解しましょう。
- SQLのパフォーマンスを左右する基本的な考え方
- 1. SELECT * を無意識に使用する
- 2. インデックスが効かない条件指定を行っている
- 3. 中間一致・後方一致の LIKE 検索
- 4. 暗黙の型変換に頼っている
- 5. OR 演算子による条件の結合
- 6. 重複排除のための DISTINCT を不必要に使用する
- 7. 相関サブクエリによる N+1 問題
- 8. UNION を UNION ALL の代わりに使用する
- 9. 不適切なインデックス設計と放置
- 10. NULL値の扱いに一貫性がない
- 11. 巨大な IN 句にリストを直接記述する
- 12. データベース側での過剰な文字列処理
- 13. トランザクションを長時間保持する
- 14. 結合条件の指定漏れ (デカルト積)
- 15. 実行計画 (EXPLAIN) を確認しない
- パフォーマンス改善に役立つ最新トレンド (2026年版)
- SQLクエリの品質を保つためのチェックリスト
- まとめ
SQLのパフォーマンスを左右する基本的な考え方
SQLは「どのようなデータが欲しいか」を記述する宣言型の言語です。
そのため、記述の仕方一つでデータベース内部の実行計画 (実行プラン) が大きく変わります。
2026年の最新データベースエンジンは非常に高度な最適化機能を備えていますが、それでも開発者の不適切な記述をすべてカバーできるわけではありません。
非効率なクエリは、CPU使用率の高騰やメモリ不足を引き起こし、最終的にアプリケーション全体のレスポンスを悪化させます。
まずは、「スキャンするデータ量を最小限に抑えること」と「インデックスを正しく活用すること」の2点を意識することが重要です。
1. SELECT * を無意識に使用する
開発の現場で最も頻繁に見かけるアンチパターンが、SELECT * による全カラムの取得です。
とりあえず全てのデータを取得しておけば安心という考えは、パフォーマンスの観点からは推奨されません。
不要なカラムを取得することで、ネットワーク帯域の無駄遣いが発生し、メモリ消費量も増加します。
特に、大きなテキストデータ (CLOBやBLOB) を含むテーブルでは、その影響は顕著に現れます。
また、テーブル定義が将来的に変更された際、意図しないデータ取得が発生し、アプリケーション側でエラーを引き起こすリスクもあります。
必要なカラムのみを明示的に指定することを習慣づけましょう。
-- 非推奨な例
SELECT * FROM users WHERE user_id = 101;

-- 推奨される例
SELECT user_id, user_name, email FROM users WHERE user_id = 101;
2. インデックスが効かない条件指定を行っている
データベースの検索を高速化する「インデックス」は、使い方を誤ると全く機能しなくなります。
よくあるミスが、WHERE句で指定するカラムに対して関数や演算を行ってしまうことです。
カラムに対して加工を行うと、データベースはインデックス済みの値を直接比較できなくなり、フルテーブルスキャン (全表走査) を選択してしまいます。
数百万件規模のデータがある場合、このミス一つでクエリ実行時間が数秒から数分に延びることもあります。
-- 非推奨:インデックスが効かない (カラムを関数で加工)
SELECT order_id FROM orders WHERE DATE_FORMAT(created_at, '%Y-%m-%d') = '2026-05-11';

-- 推奨:インデックスが効く (右辺で計算を行う)
SELECT order_id FROM orders WHERE created_at >= '2026-05-11 00:00:00' AND created_at < '2026-05-12 00:00:00';
3. 中間一致・後方一致の LIKE 検索
文字列検索で利用される LIKE 演算子も、ワイルドカード % の位置に注意が必要です。
%キーワード のように、先頭にワイルドカードを置く「中間一致」や「後方一致」の検索は、B-Treeインデックスを利用できません。
インデックスは辞書のように順番に並んでいるため、先頭が不明なキーワードは最初から最後まで探すしかないからです。
大量のテキストから高速に検索を行いたい場合は、全文検索エンジン (Elasticsearchなど) の利用を検討してください。
どうしてもSQLで対応する場合は、「前方一致 (キーワード%)」で済む設計にできないか検討しましょう。
4. 暗黙の型変換に頼っている
SQLを書く際、数値型のカラムに対して文字列として値を渡したり、その逆を行ったりしていませんか?
多くのデータベースエンジンは、データ型が異なる場合に自動的に型を変換して比較を継続します。
これを「暗黙の型変換」と呼びますが、このプロセスが発生するとインデックスが無視されることがあります。
特に数値型と文字列型の比較は、パフォーマンス低下の温床となりやすいポイントです。
クエリを発行する際は、必ずカラムの定義に合わせたデータ型で値を渡すようにしてください。
-- 非推奨:user_id が数値型の場合に文字列で検索
SELECT user_name FROM users WHERE user_id = '12345';

-- 推奨:正しい型で検索
SELECT user_name FROM users WHERE user_id = 12345;
5. OR 演算子による条件の結合
複数の検索条件を指定する際に OR を多用すると、実行プランが複雑になりパフォーマンスが低下します。
OR を使用すると、データベースはそれぞれの条件でインデックスを使用するか、あるいはスキャンを行うかの判断が難しくなるためです。
特に異なるカラムに対して OR を使用する場合は注意が必要です。
このようなケースでは、UNION ALL を使ってそれぞれの条件の結果を結合する方が、個別にインデックスが適用されやすくなり高速化する場合があります。
-- 非推奨な例
SELECT * FROM products WHERE category_id = 1 OR status = 'sale';

-- 改善案:UNION ALL を活用 (状況により実行速度が向上)
SELECT * FROM products WHERE category_id = 1
UNION ALL
SELECT * FROM products WHERE status = 'sale' AND category_id <> 1;
6. 重複排除のための DISTINCT を不必要に使用する
結合処理などでデータが重複してしまった際、安易に DISTINCT を使って解消していませんか?
DISTINCT は取得した結果セットを並び替え、重複をチェックする処理を伴うため、計算コストが非常に高い操作です。
本来は、JOINの結合条件を見直したり、EXISTS 句を使用したりすることで、重複自体を発生させない設計にするのが理想的です。
「なぜ重複が発生しているのか」の根本原因を特定せずに DISTINCT を使うのは避けましょう。
7. 相関サブクエリによる N+1 問題
メインのクエリの各行に対してサブクエリを実行する「相関サブクエリ」は、処理件数が増えると急激に重くなります。
例えば、全ユーザーに対してそれぞれの最新注文履歴を取得するような処理を相関サブクエリで書くと、ユーザー数分だけサブクエリがループ実行されます。
これはプログラムにおける「N+1問題」と同様の現象であり、大量のIOを発生させます。
2026年のモダンなSQL開発では、ウィンドウ関数 (Window Functions) を活用することで、この問題をエレガントに解決できます。
-- 非推奨:相関サブクエリ (行数分だけサブクエリが走る)
SELECT u.user_name,
       (SELECT MAX(o.order_date) FROM orders o WHERE o.user_id = u.user_id) as last_order
FROM users u;

-- 推奨:ウィンドウ関数を活用 (一度のスキャンで集計)
SELECT user_name, last_order
FROM (
    SELECT u.user_name,
           MAX(o.order_date) OVER(PARTITION BY u.user_id) as last_order
    FROM users u
    LEFT JOIN orders o ON u.user_id = o.user_id
) tmp
GROUP BY user_name, last_order;
8. UNION を UNION ALL の代わりに使用する
複数の結果セットを統合する UNION と UNION ALL には、明確な動作の違いがあります。
UNION は重複を排除するためにソート処理を行いますが、UNION ALL は重複を許容してそのまま結合します。
ビジネスロジック上、データの重複が発生しないことが明らかな場合でも UNION を使用するのは、無意味なソートコストを払っていることになります。
基本的には UNION ALL をデフォルトとし、どうしても重複排除が必要な場合にのみ UNION を選択するようにしましょう。
9. 不適切なインデックス設計と放置
インデックスは「貼れば貼るほど速くなる」というものではありません。
インデックスは検索を速くする一方で、データの更新 (INSERT, UPDATE, DELETE) の際にはインデックス自体の更新も必要になるため、書き込み負荷が増加します。
また、使用されていない古いインデックスはストレージ容量を圧迫し、データベースのメンテナンス効率を下げます。
定期的にインデックスの使用統計を確認し、利用頻度の低いインデックスを削除する メンテナンスが必要です。
また、複数のカラムを組み合わせた「複合インデックス」を作成する際は、カラムの順番も重要になります。
10. NULL値の扱いに一貫性がない
SQLにおける NULL は「値が存在しない」ことを示す特殊な状態です。
しかし、WHERE句での比較において NULL は = NULL では判定できず、IS NULL を使う必要があります。
この仕様を正しく理解していないと、意図したデータが取得できないバグの原因となります。
また、インデックスの設計においても、多くのデータベースでは NULL 値はインデックスに含まれないか、特殊な扱いとなります。
可能な限り NOT NULL制約 を設定し、デフォルト値を活用することで、ロジックをシンプルに保つことが推奨されます。
11. 巨大な IN 句にリストを直接記述する
数百、数千もの値を IN 句に直接列挙するクエリは、パフォーマンスの大敵です。
クエリのテキスト長が肥大化し、データベースエンジンによるパース (解析) 処理に時間がかかるようになります。
また、データベースによっては IN 句に指定できる要素数に上限がある場合もあります。
大量のIDでフィルタリングを行いたい場合は、一時テーブル (Temporary Table) に値を挿入し、それと JOIN させる手法を検討してください。
-- 非推奨:巨大なリスト
SELECT * FROM items WHERE item_id IN (1, 2, 3, ... 5000個のID);

-- 推奨:一時テーブルまたはサブクエリ
SELECT * FROM items WHERE item_id IN (SELECT id FROM temp_target_ids);
12. データベース側での過剰な文字列処理
SQLはデータの抽出と集計には非常に強力ですが、複雑な文字列加工には不向きです。
例えば、取得した文字列を置換したり、細かく分割したりする処理をSQL内で大量に行うと、CPU負荷が急増します。
このような処理は、データベースからデータを取得した後のアプリケーション層 (Python, Java, Goなど) で行う方が効率的です。
「データベースにしかできないこと」と「アプリケーションでできること」を明確に分離しましょう。
13. トランザクションを長時間保持する
トランザクションを開始してから完了 (COMMIT / ROLLBACK) するまでの時間が長すぎると、他のクエリをブロックする原因となります。
特に UPDATE や DELETE を伴うトランザクションは、行ロックやテーブルロックを保持し続けます。
ユーザーの入力を待機する処理をトランザクション内に含めるのは、絶対にやってはいけないことの一つです。
トランザクションは「可能な限り短く、必要な時だけ」実行するのが鉄則です。
14. 結合条件の指定漏れ (デカルト積)
JOIN を使用する際、結合条件 (ON句) を忘れると、両方のテーブルの全行を掛け合わせる「デカルト積 (CROSS JOIN)」が発生します。
1,000件のテーブルと1,000件のテーブルを誤って結合すると、100万件の結果が生成されます。
これが10万件同士であれば100億件となり、一瞬でサーバーのリソースを使い果たしてシステムダウンを招きます。
複雑な結合を行う際は、必ず実行前に結合条件が正しいことを確認する習慣をつけてください。
15. 実行計画 (EXPLAIN) を確認しない
どれだけ経験豊富なエンジニアでも、複雑なクエリがどのように実行されるかを完璧に予測することは不可能です。
クエリのパフォーマンスが遅いと感じたとき、あるいは重要なクエリを本番環境に投入する前には、必ず EXPLAIN 命令を使って実行計画を確認してください。
実行計画を見れば、どのインデックスが使われているか、どのテーブルでフルスキャンが発生しているかが一目でわかります。
2026年現在は、GUIツールで実行計画を可視化する機能も充実しているため、これらを積極的に活用しましょう。
-- 実行計画を確認するコマンド例
EXPLAIN ANALYZE
SELECT user_name FROM users WHERE user_id = 500;-> Index Scan using users_pkey on users (cost=0.28..8.30 rows=1 width=12) (actual time=0.015..0.016 rows=1 loops=1)
Index Cond: (user_id = 500)
Planning Time: 0.082 ms
Execution Time: 0.034 msパフォーマンス改善に役立つ最新トレンド (2026年版)
2026年、SQLの世界では AI によるクエリ最適化が標準化しつつあります。
多くのクラウドデータベースでは、実行統計に基づき、最適なインデックスを自動でアドバイスしたり、動的にクエリプランを書き換えたりする機能が搭載されています。
しかし、これらも万能ではありません。
開発者が記述した SQL の構造が根本的に悪い場合、AI の補正にも限界があるからです。
また、カラムナ型データベース (BigQuery, Snowflakeなど) の普及により、従来の行指向データベースとは異なるチューニング手法も求められています。
基本となるアンチパターンを回避した上で、プラットフォーム特有の最適化技術を取り入れていく姿勢が重要です。
SQLクエリの品質を保つためのチェックリスト
日々の開発の中で、品質を一定に保つための簡易的なチェックリストを用意しました。
プルリクエストを出す前や、コードレビューの際に活用してください。
| チェック項目 | 確認内容 |
|---|---|
| カラム指定 | SELECT * を使わず、必要なカラムのみ指定しているか? |
| インデックスの有効活用 | WHERE句のカラムに余計な加工 (関数適用など) をしていないか? |
| ワイルドカードの位置 | LIKE 検索で先頭に % が付いていないか? |
| 結合の妥当性 | 適切な JOIN 条件が設定されているか? (デカルト積の回避) |
| 実行計画の確認 | EXPLAIN で意図したインデックスが使われているか? |
まとめ
SQLは非常に柔軟な言語ですが、その自由度の高さゆえに「動くけれども遅い」コードが生まれやすい特性を持っています。
今回紹介した15の慣習は、いずれもパフォーマンスや保守性を低下させる典型的な要因です。
特に、「不要なデータの取得を避け、インデックスを最大限に活用すること」は、時代が変わっても変わらない鉄則です。
2026年の高度なデータベース環境においても、基礎となるSQLスキルの有無がシステムの成否を分けます。
自身のクエリを客観的に振り返り、より洗練されたSQLを記述することで、高速で信頼性の高いアプリケーションを構築していきましょう。
日々の小さな改善の積み重ねが、将来的に大きなパフォーマンスの差となって現れるはずです。