
大規模言語モデル(LLM)の活用が急速に進む中、多くの企業が直面している課題が「推論インフラの効率化」です。
特にゲーム業界の大手であるNetEase Games(網易)は、高度なNPCやコンテンツ生成のために大規模なLLMを本番環境で運用しており、そのデータ移動に伴う遅延に悩まされてきました。
計算リソースであるGPUが確保できても、数百GBに及ぶモデルデータの読み込みに時間がかかれば、オートスケーリングの利点は失われてしまいます。
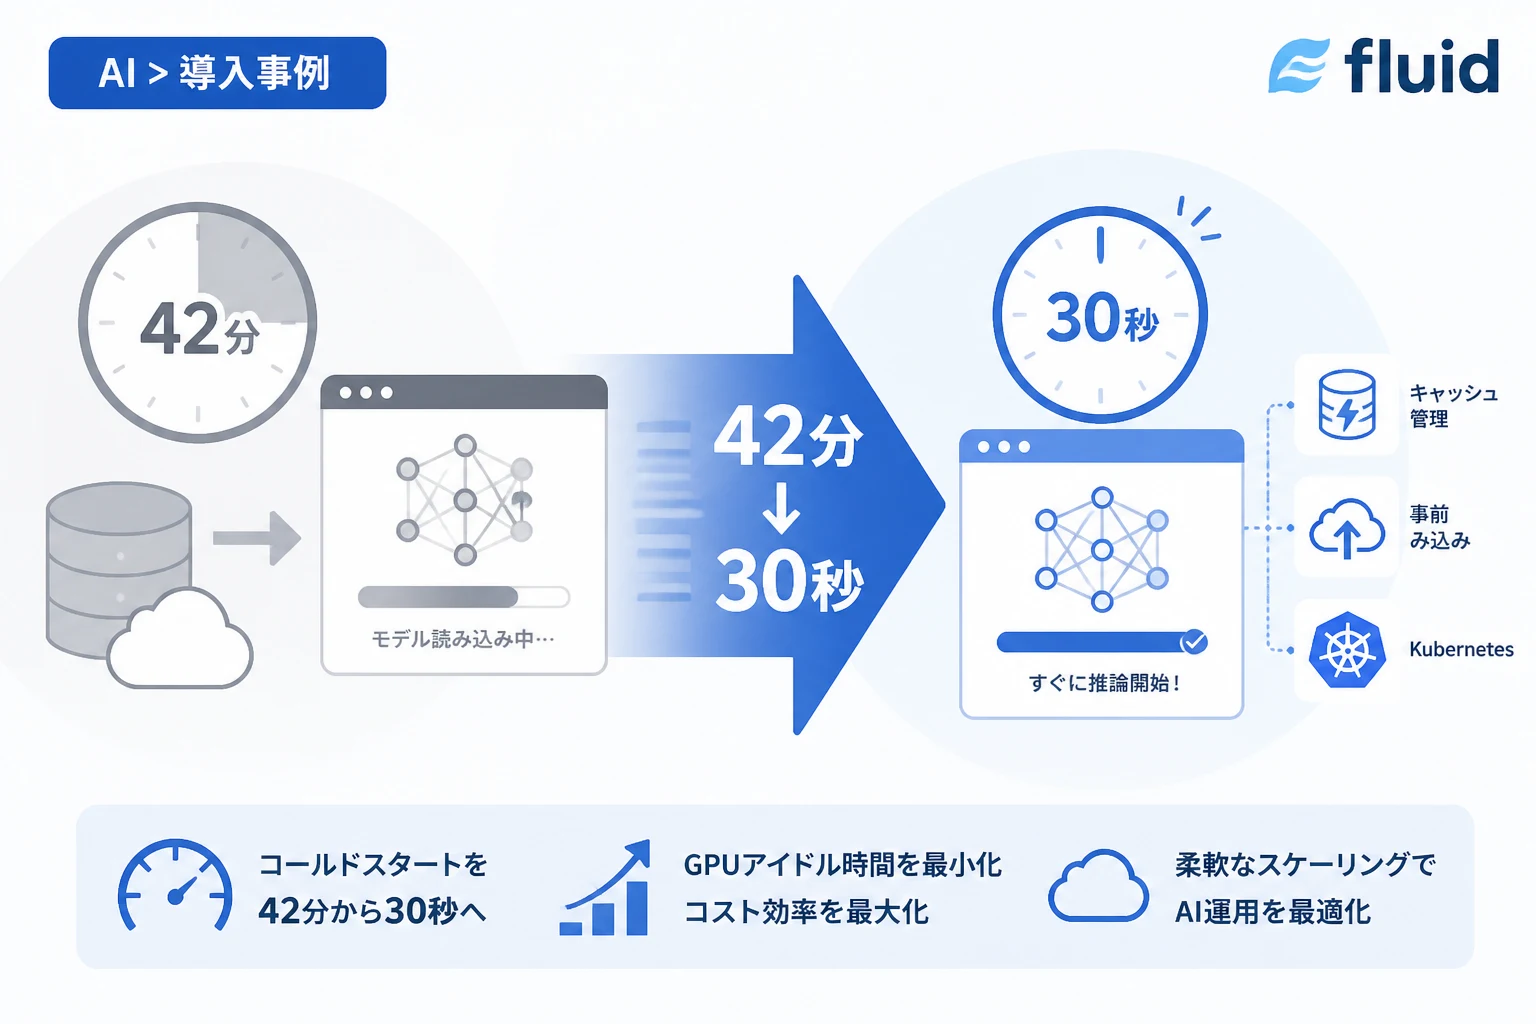
本記事では、NetEase GamesがCloud Native Computing Foundation(CNCF)のプロジェクトである「Fluid」を導入し、LLMのコールドスタート時間を42分からわずか30秒へと劇的に短縮した手法について深く掘り下げます。
LLM推論における「コールドスタート」という致命的なボトルネック
クラウドネイティブな環境において、サーバーレスGPUインフラストラクチャは一見すると推論ワークロードに最適であるように思えます。
ゲームのトラフィックはタイトルや時間帯によって激しく変動するため、常に最大負荷に合わせたGPUキャパシティを予約しておくことは、膨大なコスト増を招くからです。
しかし、NetEase GamesがLLMサービスを複数のリージョンにスケールさせ始めた際、コンテナのスケジューリングよりも深刻な問題が浮上しました。
それは、リモートストレージから推論ノードへ数百ギガバイトものモデル重みデータをロードするプロセスです。
70B(700億パラメータ)クラスのモデルを別リージョンのストレージから直接読み込む場合、その完了までに42分もの時間を要していました。
これでは、急激なユーザー増加に応じてインスタンスを増やしたとしても、実際にサービスが開始される頃にはピークが過ぎ去ってしまいます。
この「データ移動の遅延」こそが、サーバーレス推論を実用化する上での最大の障害となっていたのです。
NetEaseのAIプラットフォーム「Tmax」が抱えていた3つの課題
NetEaseのAIプラットフォームである「Tmax」は、Kubernetes上でMLライフサイクル全体をサポートしていますが、運用の拡大に伴い以下の課題が顕在化しました。
1. GPUリソースの希少性と不均一性
ワークロードごとに必要なGPUの種類やメモリサイズが異なり、すべてのチームに十分なリソースを常時割り当てることは極めて非効率でした。
2. 非一様なトラフィックパターン
タイトルごとにピーク時間が異なるため、静的なプロビジョニングではリソースの利用率が低下し、無駄なコストが発生していました。
3. データパスによるコールドスタートの長期化
計算リソースが即座に利用可能になっても、モデルデータのロードが完了するまで推論サービスは「準備中」のまま停滞してしまいます。
Fluid:Kubernetesネイティブなデータオーケストレーション
NetEase Gamesはこの問題を解決するために、CNCFのインキュベーティングプロジェクトである「Fluid」を採用しました。
Fluidは単なるキャッシュシステムではなく、Kubernetes環境において「データセット」を第一級オブジェクトとして扱うためのオーケストレーターです。
従来のキャッシュソリューションであるAlluxioなどを抽象化し、データのプリウォーム(事前読み込み)やスケーリング、ネームスペース間での共有を統合的に管理します。
なぜAlluxioを直接運用するだけでは不十分だったのか
Alluxioは強力な分散キャッシュですが、Kubernetes上で直接運用する場合、プラットフォームチームにとって管理上のオーバーヘッドが大きくなります。
以下の表は、Alluxioを直接運用する場合と、Fluidを導入した場合の運用上の違いをまとめたものです。
| 比較項目 | Alluxio直接運用 | Fluidによる拡張 |
|---|---|---|
| K8s統合 | クラスターの展開・管理が個別 | カスタムリソース(CRD)によるネイティブ管理 |
| スケーラビリティ | 手動、あるいは複雑なスクリプト | HPAやKEDAとの親和性が高く、自動スケールが可能 |
| データプリフェッチ | カスタムロジックの構築が必要 | ワークフロー機能による事前ロードの自動化 |
| チーム間共有 | 手動でのディレクトリ管理が困難 | ネームスペースを越えた論理的なデータ共有 |
Fluidによるデータセット定義の例
Fluidを使用すると、開発者はYAMLファイルを通じてモデルデータを「Dataset」として定義できます。
以下は、リモートのS3互換ストレージにあるLLMモデルをFluidで定義し、事前読み込み(DataBackup / Prefetch)を行う際の構成イメージです。
apiVersion: data.fluid.io/v1alpha1
kind: Dataset
metadata:
  name: llm-model-70b
spec:
  mounts:
    - mountPoint: "s3://models/llama3-70b/"
      name: llama3
      options:
        aws.s3.endpoint: "https://s3.region.amazonaws.com"
---
apiVersion: data.fluid.io/v1alpha1
kind: AlluxioRuntime
metadata:
  name: llm-model-70b
spec:
  replicas: 5
  tieredstore:
    levels:
      - mediumtype: MEM
        path: /dev/shm
        quota: 200Gi
この定義により、Kubernetesクラスター内の各ノードのメモリ上にモデルデータがキャッシュされ、推論Podからのアクセスが極めて高速化されます。
劇的な改善結果:42分から30秒への短縮
Fluidを導入し、本番環境でチューニングを重ねた結果、NetEase Gamesは驚異的なパフォーマンス向上を達成しました。
当初、リージョンを跨いだ直接アクセスで42分かかっていたモデルのロード時間は、従来のキャッシュ導入で14分まで短縮されました。
さらに、Fluidのプリフェッチ(事前取得)ワークフローを有効化することで、この時間は3分へと激減しました。
最終的な最適化の後、特定の条件下ではコールドスタートが30秒未満にまで短縮されるケースも確認されています。
コスト削減と運用効率の向上
このレイテンシの劇的な低減は、単なるユーザー体験の向上に留まりません。
スケーリングが迅速に行えるようになったことで、アイドル状態のGPUリソースを最小限に抑えることが可能になりました。
また、ネームスペースを跨いだデータの共有機能により、同じベースモデルを複数のチームが個別にキャッシュする必要がなくなりました。
これにより、クラスター全体のメモリ消費量が削減され、インフラ全体のコスト効率が大幅に向上したのです。
まとめ
NetEase Gamesの事例は、LLM推論を成功させる鍵が「計算能力(GPU)」だけでなく「データ移動の最適化」にあることを明確に示しています。
Fluidのようなデータオーケストレーション層を導入することで、Kubernetesネイティブな運用を実現しつつ、ストレージのボトルネックを解消できることが証明されました。
「弾力性のある計算リソースは、データが同じ速さで移動できて初めて意味を成す」という教訓は、今後AIプラットフォームを構築するすべての企業にとって重要な指針となるでしょう。
大規模なモデルをいかに迅速に、かつコスト効率よくデプロイするかという課題に対し、Fluidは非常に強力な解決策を提供します。