
Go言語は、シンプルさを保ちながらも、開発者の利便性を向上させるための進化を続けています。
特に近年、ループ処理を担う for range 文には、これまでの定石を覆すような強力なアップデートが加えられました。
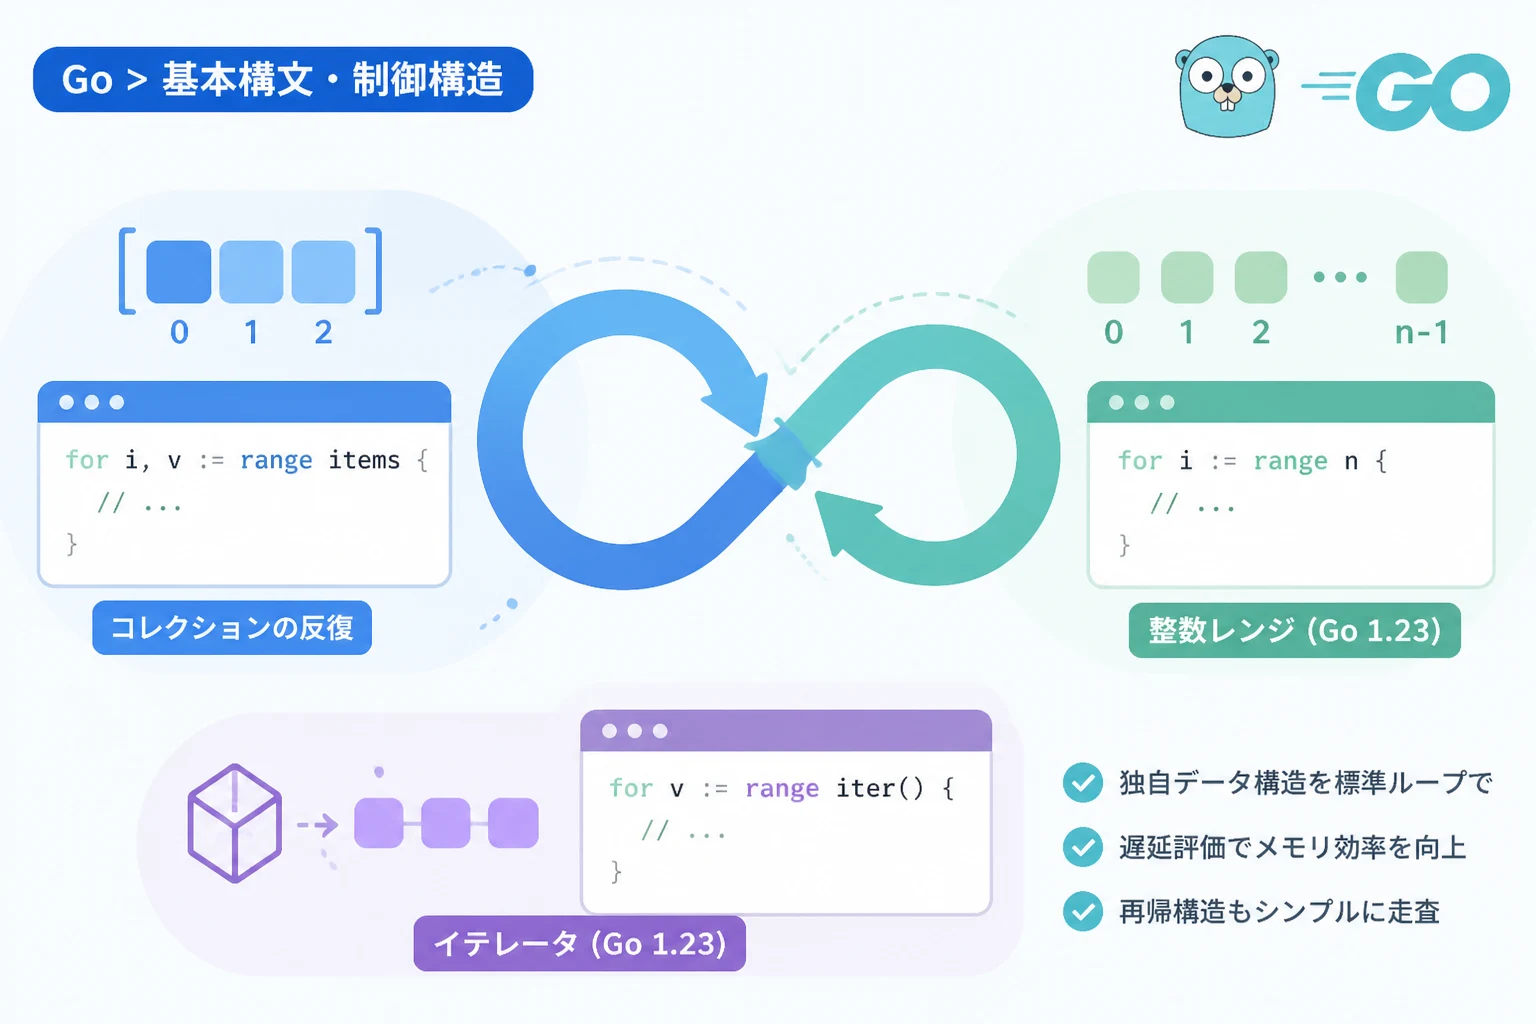
2024年のGo 1.22による整数レンジの導入、そしてGo 1.23で正式採用されたイテレータ(Range-over-func)は、現代のGo開発において必須の知識となっています。
本記事では、最新の for range 仕様がどのように変化し、私たちのコーディングにどのような影響を与えるのかを詳しく解説します。
Go言語における反復処理の基本と進化の背景
Go言語の for range は、スライス、配列、マップ、チャネルといったデータ構造を走査するための構文として親しまれてきました。
従来の仕様では、これらの組み込み型に対してのみ range を使用することが可能でした。
しかし、標準ライブラリ以外の独自のデータ構造や、複雑なフィルタリングを伴う走査を行う際には、標準の for range だけでは表現力が不足する場合がありました。
また、指定した回数だけループを回す際にも、従来の C-style である for i := 0; i < n; i++ という記述が必要でした。
これらの制約を解消し、より宣言的で再利用性の高いコードを実現するために、for range は大幅に拡張されました。
スライスとマップの基本動作の再確認
まずは、基本となるスライスとマップでの for range の挙動を整理しておきましょう。
package main

import "fmt"

func main() {
    // スライスの反復処理
    nums := []string{"Go", "Rust", "Python"}
    for i, v := range nums {
        fmt.Printf("Index: %d, Value: %s\n", i, v)
    }

    // マップの反復処理
    scores := map[string]int{"Alice": 90, "Bob": 85}
    for key, val := range scores {
        fmt.Printf("Key: %s, Value: %d\n", key, val)
    }
}Index: 0, Value: Go
Index: 1, Value: Rust
Index: 2, Value: Python
Key: Alice, Value: 90
Key: Bob, Value: 85スライスでは「インデックス」と「要素」が、マップでは「キー」と「値」が取得できるという点は、現在も変わりません。
しかし、Go 1.22以降、この range キーワードの右側に「整数」を置くことができるようになりました。
Go 1.22で導入された整数ループ(Range over integer)
従来のGo言語で「n回繰り返す」という処理を記述する場合、初期化式、条件式、後続処理を記述する冗長な構文が必要でした。
Go 1.22からは、for i := range n という簡潔な記述がサポートされています。
これにより、ループ回数を直接指定することが可能になり、コードの可読性が飛躍的に向上しました。
整数レンジの具体的な記述例
以下のコードは、0から9までの数値を順に表示する例です。
package main

import "fmt"

func main() {
    // 10回繰り返す処理
    for i := range 10 {
        fmt.Print(i, " ")
    }
}0 1 2 3 4 5 6 7 8 9この構文において、変数 i は 0 から n-1 までの値を取ります。
もしループ内でインデックスを使用しない場合は、単に for range 10 { ... } と記述することも可能です。
オフバイワンエラー(1のズレによるバグ)を防ぐ効果もあり、非常にモダンな書き方と言えます。
Go 1.23の核心:イテレータ(Range-over-func)
最新のGo言語において最も重要な変更が、関数を range で回すことができるようになった「イテレータ」の導入です。
これにより、開発者は独自のデータ構造に対して、標準の for range を利用した走査インターフェースを提供できるようになりました。
この機能は、Go 1.23で正式に導入され、iter パッケージとして型定義が提供されています。
イテレータの基本型:iter.Seq と iter.Seq2
イテレータは、特定のシグネチャを持つ関数として定義されます。
標準ライブラリでは、以下の2つの型が主要な役割を果たします。
| 型名 | 説明 |
|---|---|
iter.Seq[V] | 1つの値を返すイテレータ (スライスの値のみのような形式) |
iter.Seq2[K, V] | 2つの値を返すイテレータ (マップのキーと値のような形式) |
これらの型は、実体としては yield と呼ばれる関数を引数に取る高階関数です。
yield 関数が false を返した場合、イテレータは即座に停止しなければならないというルールがあります。
独自のイテレータを実装する
実際に、独自の「偶数のみを返すイテレータ」を実装してみましょう。
package main

import (
    "fmt"
    "iter"
)

// 0からmaxまでの偶数を返すイテレータ
func Evens(max int) iter.Seq[int] {
    return func(yield func(int) bool) {
        for i := 0; i <= max; i++ {
            if i%2 == 0 {
                // yieldを呼び出し、継続の可否を確認する
                if !yield(i) {
                    return
                }
            }
        }
    }
}

func main() {
    // 独自のイテレータをfor rangeで利用
    for n := range Evens(10) {
        fmt.Print(n, " ")
    }
}0 2 4 6 8 10このように、複雑なロジックをカプセル化したまま、利用側はシンプルな for range を使えるようになります。
これは、Goにおける抽象化の強力な武器となります。
標準ライブラリにおけるイテレータの活用
Go 1.23以降、標準ライブラリの既存パッケージにもイテレータを返すメソッドが追加されています。
例えば、slices パッケージや maps パッケージでは、これまで以上に柔軟な走査が可能になりました。
slicesパッケージのAllとValues
従来、スライスの全要素を回すには for i, v := range slice と書いていました。
現在は、slices.All(slice) を使うことで、イテレータとして扱うことができます。
package main

import (
    "fmt"
    "slices"
)

func main() {
    names := []string{"Alice", "Bob", "Charlie"}

    // slices.AllはSeq2[int, T]を返す
    for i, name := range slices.All(names) {
        fmt.Printf("%d: %s\n", i, name)
    }
}
一見すると従来の range と変わりませんが、「イテレータを引数に取る汎用的な関数」にそのまま渡せるようになった点に大きな価値があります。
mapsパッケージのイテレータ
マップにおいても、maps.Keys や maps.Values といった関数が提供されています。
これにより、マップのキーだけをスマートに抽出してループに回すことが可能になりました。
package main

import (
    "fmt"
    "maps"
)

func main() {
    m := map[string]int{"Go": 2009, "Rust": 2010}

    // キーだけを取得して走査
    for key := range maps.Keys(m) {
        fmt.Println(key)
    }
}
中間のスライスを作成することなく走査できるため、メモリ効率が向上します。
イテレータ導入によるメリットとパフォーマンス
新しい for range 仕様、特にイテレータの導入には多くのメリットがあります。
まず、「遅延評価(Lazy Evaluation)」が可能になる点です。
大量のデータセットを扱う場合、すべての要素をメモリ上に展開してからループを回すのは効率的ではありません。
イテレータを使用すれば、必要な時に必要な分だけデータを生成・取得できるため、メモリ消費を劇的に抑えることができます。
パフォーマンス上の留意点
イテレータは関数呼び出しを伴うため、極限のパフォーマンスが求められるホットループでは、従来のスライス操作よりもわずかにオーバーヘッドが発生する可能性があります。
しかし、現代のGoコンパイラは非常に優秀であり、多くの場合でその差は無視できるレベルです。
それ以上に、コードの再利用性や安全性が向上するメリットの方が大きいと言えるでしょう。
実践的なユースケース:ツリー構造の走査
イテレータが真価を発揮するのは、再帰的な構造を持つデータの走査です。
例えば、二分木のインオーダー走査(左→根→右)を for range で実現する場合を考えてみましょう。
type Node struct {
    Val   int
    Left  *Node
    Right *Node
}

func (n *Node) All() iter.Seq[int] {
    return func(yield func(int) bool) {
        if n == nil {
            return
        }
        // 左の子を再帰的に走査
        for v := range n.Left.All() {
            if !yield(v) { return }
        }
        // 自身の値をyield
        if !yield(n.Val) { return }
        // 右の子を再帰的に走査
        for v := range n.Right.All() {
            if !yield(v) { return }
        }
    }
}
このように実装することで、利用者は内部の再帰ロジックを意識することなく、単なる for v := range node.All() としてデータを取得できます。
これはオブジェクト指向におけるイテレータパターンを、Goらしい簡潔さで実現したものです。
注意点とベストプラクティス
新しい for range を活用するにあたって、いくつか注意すべきポイントがあります。
1. yieldの戻り値を必ずチェックする
イテレータ内部で yield を呼び出す際、その戻り値(bool)を無視してはいけません。
もし false が返ってきた場合、それはループ側で break が実行されたことを意味します。
このチェックを怠ると、ループが終了しているのに関数内の処理が継続されてしまうというバグの原因になります。
2. リソースの解放を確実に行う
ファイルやネットワークコネクションを走査するイテレータを作成する場合、yield が false を返した際のクリーンアップ処理を忘れないようにしましょう。
Go 1.23では、プル型イテレータ(Pull iterators)という、より制御の細かい仕組みも導入されていますが、通常の range-over-func では関数の終了がクリーンアップのタイミングとなります。
3. 無闇にイテレータを使いすぎない
単純なスライスの走査であれば、従来の for i, v := range slice の方が意図が明確な場合もあります。
「ロジックの隠蔽」や「遅延評価」が必要な場面において、イテレータを選択するのが賢明です。
まとめ
Go言語の for range は、単なるループ構文から、強力な抽象化ツールへと進化を遂げました。
整数レンジによる記述の簡略化から、イテレータによる高度なデータ走査まで、その活用範囲は非常に多岐にわたります。
特に iter.Seq や iter.Seq2 を活用した設計は、これからのGoライブラリ開発においてスタンダードな手法となるでしょう。
本記事で紹介した最新の仕様を理解し、適切に使い分けることで、より堅牢でメンテナンス性の高いGoプログラムを記述できるようになります。
まずは日々のコードの中で、for i := range n のような小さな改善から取り入れてみてはいかがでしょうか。
最新の言語仕様を味方につけ、モダンなGo開発を楽しんでいきましょう。