
AIエージェントのビジネス活用が急速に進む中で、多くの開発者が「実運用におけるデータの壁」に直面しています。
従来のAIエージェントは、回答を生成するために実行時(ランタイム)に複数のSaaSツールのAPIを呼び出し、バラバラの情報をその場で統合する必要がありました。
しかし、この手法は高いレイテンシ(遅延)やトークン消費の増大、そしてデータの不整合という深刻な課題を抱えています。
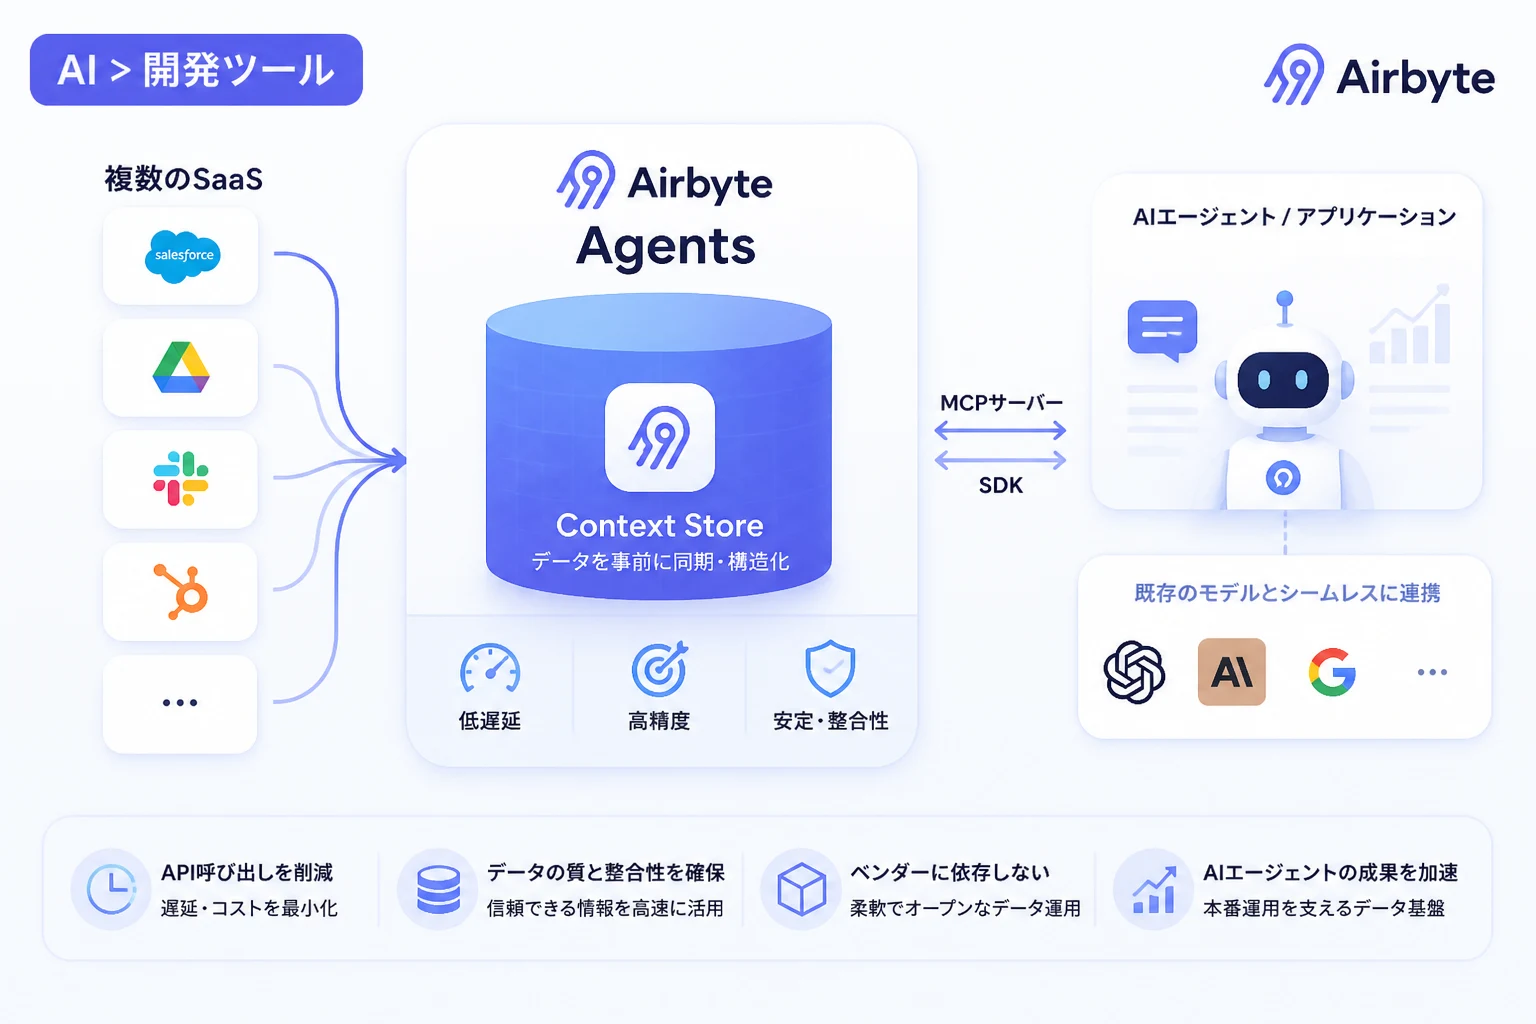
データ統合プラットフォームのリーダーであるAirbyteは、これらの課題を解決するために、AIエージェント専用の新しいデータレイヤー「Airbyte Agents」を発表しました。
このサービスは、散らばったビジネスデータを事前に集約・構造化し、AIが直接クエリ可能な状態に保つことで、エージェントの精度と速度を劇的に向上させます。
エージェント運用のボトルネックを解消する設計思想
AirbyteのCEOであるMichel Tricot氏は、「AIエージェントの失敗の多くはモデルの性能不足ではなく、データの不備に起因する」と断言しています。
エージェントがSalesforce、Zendesk、Slackなどの複数のシステムから情報を継ぎ接ぎして回答を作ろうとすると、システムの数だけAPI呼び出しが発生します。
この「APIの乱立」が、実運用における信頼性を著しく低下させているのが現状です。
高コストな「APIスプロール」の回避
一つの質問に答えるために5〜6個のAPIを叩く構造では、応答待ちの時間が長くなり、ユーザー体験が損なわれます。
また、API経由で取得した膨大なコンテキストをモデルに流し込むことで、トークンコストが膨れ上がるという経済的なデメリットも無視できません。
Airbyte Agentsは、この非効率なワークフローを根本から変え、情報の取得先を一つの構造化されたインデックスに集約します。
Context Store:RAGとAPIの課題を補完する新概念
Airbyte Agentsの中核となるのが「Context Store」と呼ばれる機能です。
これは、SalesforceやJira、Slackなどのデータを事前に同期し、エンティティの履歴や現在の状態を保持したままインデックス化する仕組みです。
従来のRAG(検索拡張生成)や単純なAPI連携とは異なり、システム間の関係性を維持したままデータを保持する「永続的かつ構造化されたレイヤー」として機能します。
データ取得手法の比較
以下の表は、従来のAPI連携手法とAirbyte Agentsによるアプローチを比較したものです。
| 比較項目 | 従来のAPI/RAG連携 | Airbyte Agents (Context Store) |
|---|---|---|
| データ取得タイミング | 実行時に都度APIを呼び出し | 事前に同期・インデックス化済み |
| API呼び出し回数 | 多数(連携システム数に比例) | 1〜2回(最小限のクエリ) |
| 一貫性の確保 | 実行時の状態に依存(不整合リスクあり) | Context Storeが状態の整合性を管理 |
| レイテンシ | 高い(ネットワーク遅延の蓄積) | 極めて低い |
実装の柔軟性:MCPとAgent SDK
Airbyte Agentsは、開発者が既存のワークフローに組み込みやすいよう、2つの主要なアクセス方法を提供しています。
一つは「Airbyte MCP(Model Context Protocol)サーバー」で、これによりClaudeやChatGPTといったツールからコードを書かずにデータを参照できます。
もう一つは、プログラムから高度な制御を可能にする「Agent SDK」です。
SDKを利用した実装例
SDKを使用することで、エンジニアはカスタムエージェントがContext Storeからどのようにデータを読み書きするかを詳細に制御できます。
# Airbyte Agent SDKを使用してコンテキストを取得する例
from airbyte_agents import AirbyteAgentClient

# クライアントの初期化
client = AirbyteAgentClient(api_key="your_api_key")

# Context Storeから特定のビジネスコンテキストを検索
# 複数のSaaSを横断した検索が1つのクエリで完結
context = client.search_context(
    query="Jiraの課題番号-123に関連するSalesforceの商談状況を教えて",
    limit=5
)

# 取得した構造化データを出力
print(context.results)[
{
"source": "Salesforce",
"entity": "Opportunity",
"status": "Closed Won",
"related_jira_issue": "PROJ-123"
},
{
"source": "Jira",
"entity": "Issue",
"key": "PROJ-123",
"summary": "API統合の不具合対応"
}
]激化するAIデータレイヤー市場の展望
Airbyteのこの動きは、FivetranやSalesforce(Agentforce)といった競合他社がひしめく市場への強力な挑戦状です。
特に、特定のベンダーに依存しない「ベンダーニュートラル」なデータレイヤーとしての立ち位置は、多種多様なSaaSを利用する現代の企業にとって大きな魅力となります。
また、ノーコードでエージェントのワークフローを構築できる「Automations」機能のプレビュー公開も、開発の民主化を後押しするでしょう。
まとめ
AIエージェントの真の価値を引き出すためには、単に優れたモデルを使うだけでなく、「いかに整理されたデータに低遅延でアクセスできるか」が鍵となります。
Airbyte Agentsは、Context Storeという新しい層をスタックに加えることで、この難問に対する現実的かつ強力な解を提示しました。
50以上のコネクタを携えてスタートしたこの取り組みは、今後さらに対象を拡大し、AI開発における「データのハブ」としての地位を確立していくことが予想されます。
企業がAIエージェントをプロトタイプから本番環境へと移行させる際、Airbyte Agentsは不可欠なインフラとなる可能性を秘めています。