
システム開発において、データベースとの対話は避けて通れない要素です。
しかし、アプリケーションが成長しデータ量が増加するにつれて、SQL発行の効率性がシステム全体のパフォーマンスを左右する決定的な要因となります。
適切なSQLを発行できているか、そしてその裏側でどのような処理が行われているかを理解することは、エンジニアにとって必須のスキルと言えるでしょう。
本記事では、SQLが発行されてから結果が返るまでの仕組みと、実行効率を劇的に改善するための最適化手法について詳しく解説します。
SQL発行の内部プロセスとその重要性
SQLを発行するという行為は、単にデータベースに命令を送るだけではありません。
データベース管理システム (DBMS) の内部では、効率的にデータを抽出するために複雑な工程を経て処理が実行されています。
このプロセスを知ることは、なぜ特定のクエリが遅いのか、どのように改善すべきかを考える上での土台となります。
クエリ実行のライフサイクル
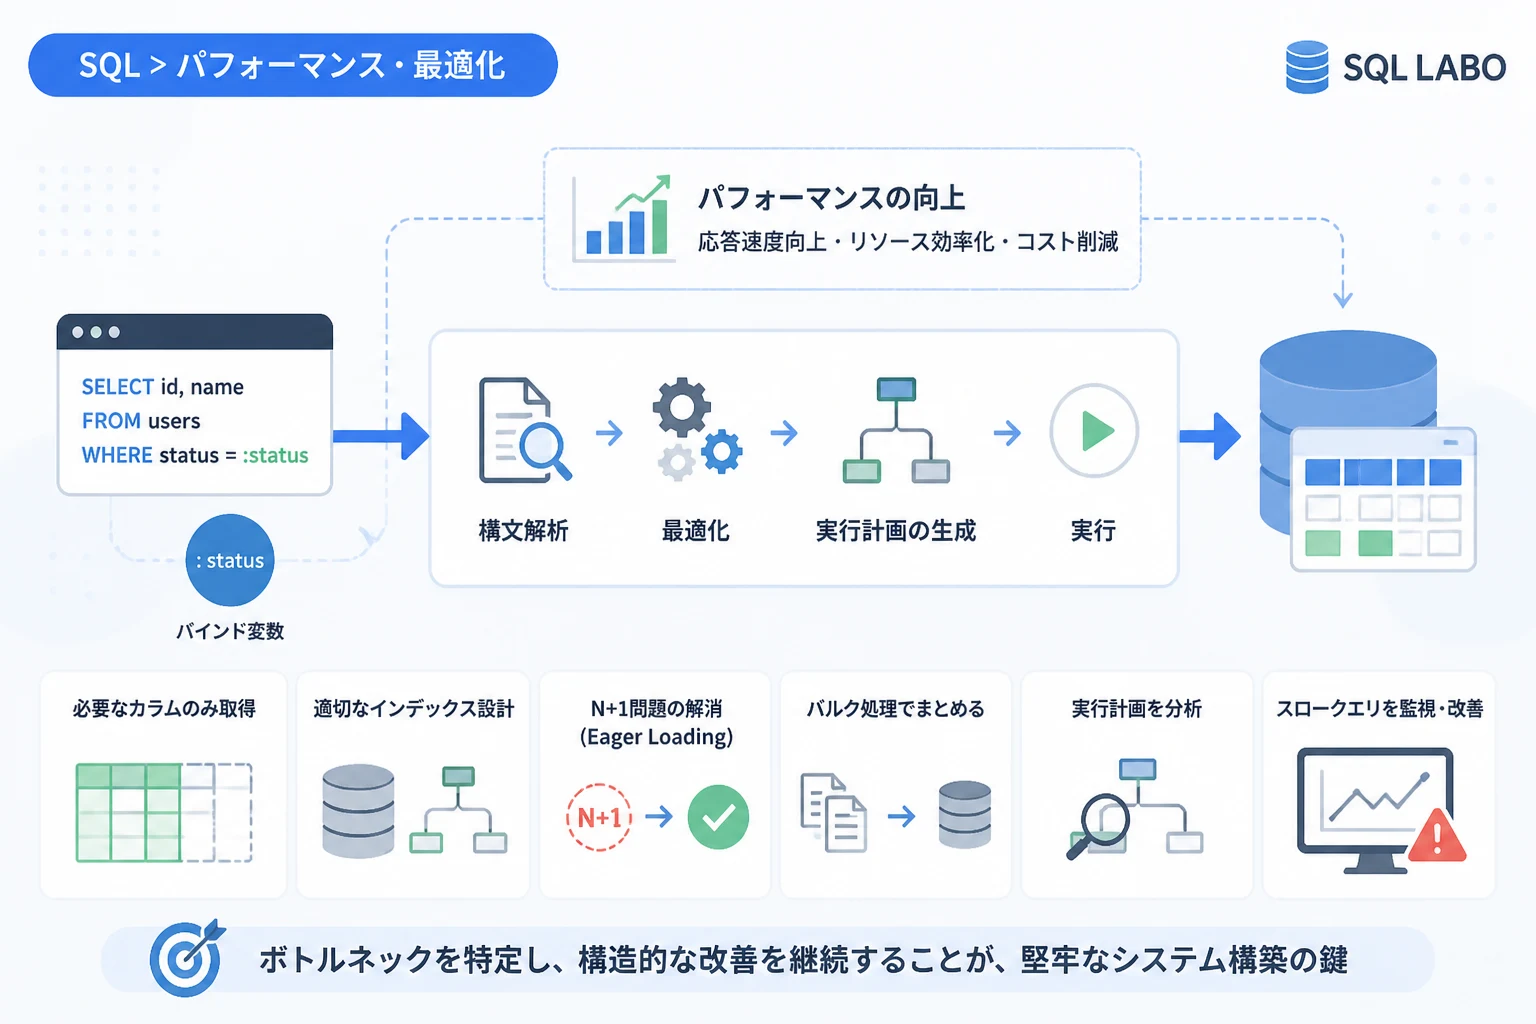
SQLがアプリケーションからデータベースへ送信されると、主に以下の4つのフェーズを経て処理されます。
- パーサ (Parser) による構文解析
- セマンティック解析 (意味解析)
- オプティマイザ (Optimizer) による最適化
- 実行エンジン (Executor) によるデータ処理
まず、パーサは受け取ったSQLの構文が正しいかどうかを確認します。
キーワードの綴りミスや括弧の閉じ忘れなどがないかをチェックし、その後にセマンティック解析によって「指定されたテーブルやカラムが実際に存在するか」「実行ユーザーに権限があるか」を検証します。
このフェーズでエラーが見つかれば、データベースは即座にエラーを返します。
オプティマイザの役割と実行計画の生成
SQL発行において最も重要なのが、このオプティマイザによる最適化のプロセスです。
SQLは「何をしたいか」を記述する宣言型の言語であり、「どのように処理するか」はDBMSに委ねられます。
オプティマイザは、統計情報を基に数ある処理パターンの中から、最もコストが低いと思われる手順を選択します。
この選択された手順が「実行計画 (Execution Plan)」です。
インデックスを使うのか、フルテーブルスキャンを行うのか、テーブルの結合順序はどうするかといった戦略はすべてここで決定されます。
SQL発行の最適化とは、突き詰めればオプティマイザに最適な実行計画を選択させることに他なりません。
効率的なSQL発行のための具体的テクニック
パフォーマンスを改善するためには、データベース側の負荷を最小限に抑えるようなSQL発行を心がける必要があります。
ここでは、明日から実戦で使える主要な最適化手法を紹介します。
バインド変数の活用によるソフトパースの促進
SQLを発行する際、値を直接クエリ文字列に埋め込むのではなく、バインド変数 (プレースホルダ) を使用することが推奨されます。
-- 推奨されない例:値を直接埋め込む (リテラルSQL)
SELECT * FROM users WHERE user_id = 123;

-- 推奨される例:バインド変数を使用
SELECT * FROM users WHERE user_id = ?;
リテラルSQLを使用すると、値が異なるたびに新しいSQLとして認識され、毎回「ハードパース」が発生します。
ハードパースはCPU負荷が高く、並列実行時のボトルネックになります。
一方、バインド変数を使用すれば、DBMSは一度解析した実行計画を再利用できるため、パース処理のオーバーヘッドを大幅に削減できます。
これはセキュリティ面での SQLインジェクション対策 としても不可欠です。
取得カラムの限定と「SELECT *」の回避
開発時に便利だからといって SELECT * を多用するのは避けましょう。
不要なカラムまで取得することは、ネットワーク帯域の浪費だけでなく、データベース内部でのメモリ消費やI/O負荷の増大を招きます。
-- 悪い例
SELECT * FROM orders WHERE status = 'pending';

-- 良い例
SELECT order_id, customer_id, order_date FROM orders WHERE status = 'pending';特に、後述するインデックスの活用において、必要なカラムだけをSELECT対象にすることで、カバリングインデックス (インデックス内のデータだけでクエリを完結させる手法) が適用可能になり、テーブル本体へのアクセスをスキップできる場合もあります。
インデックスの適切な設計と利用
SQL発行の高速化において、インデックスの右に出るものはありません。
インデックスは、書籍の索引のように目的のデータへ最短距離で到達するための構造です。
| インデックスの種類 | 特徴 | 適したケース |
|---|---|---|
| B-Treeインデックス | 汎用性が高く、等価比較や範囲検索に強い | 主キー、外部キー、検索頻度の高いカラム |
| 複合インデックス | 複数のカラムを組み合わせたインデックス | 複数条件を組み合わせた検索 |
| カバリングインデックス | SELECT対象のカラムがすべてインデックスに含まれる | 高速な読み取り専用クエリ |
ただし、インデックスは作成すればするほど良いというわけではありません。インデックスはデータの挿入・更新・削除のたびにメンテナンスが必要なため、過剰なインデックスは書き込みパフォーマンスを低下させます。
参照と更新のバランスを考慮した設計が求められます。
アプリケーション層からのSQL発行における注意点
現代の開発では、ORM (Object-Relational Mapping) を介してSQLを発行することが一般的です。
ORMは生産性を高めますが、意図しない非効率なSQL発行を引き起こす原因にもなります。
N+1問題の特定と解消
SQL発行に関するパフォーマンス課題で最も頻出するのが N+1問題 です。
これは、1回のクエリで親データを取得した後、その子データを取得するためにレコード数分のSQLを追加で発行してしまう現象を指します。
-- 1回目のSQL発行 (親データの取得)
SELECT * FROM departments;

-- 2回目以降のSQL発行 (各部門に属する社員を取得:N回繰り返される)
SELECT * FROM employees WHERE department_id = 1;
SELECT * FROM employees WHERE department_id = 2;
-- ...以下、部門の数だけ続くこれを解決するには、Eager Loading (一括読み込み) を使用します。
結合 (JOIN) や IN 句を用いて、1回または数回のSQL発行で必要なデータをすべて取得するように修正します。
-- Eager Loadingによる改善例 (JOINを使用)
SELECT d.*, e.*
FROM departments d
LEFT JOIN employees e ON d.department_id = e.department_id;
このようにSQL発行回数を最小限に抑えることで、データベースサーバーとの往復回数 (Round Trip) が減り、アプリケーションの応答速度が劇的に向上します。
大量データ更新におけるバッチ処理
数万件、数百万件のデータを1件ずつ INSERT または UPDATE することは、トランザクションのオーバーヘッドが膨大になるため非常に非効率です。
このような場合は、バルクインサート (Bulk Insert) を活用します。
-- 非効率な例:ループ内で1件ずつ発行
INSERT INTO logs (message) VALUES ('log1');
INSERT INTO logs (message) VALUES ('log2');

-- 効率的な例:1つのSQLでまとめて発行
INSERT INTO logs (message) VALUES
('log1'),
('log2'),
('log3');
SQL発行の単位を適切にまとめることで、ログの書き出しやインデックスの更新負荷を一括処理でき、処理時間を短縮できます。
ボトルネックの特定と分析ツール
最適化を行う前には、必ず現状の分析が必要です。
感覚で修正を加えるのではなく、数値的な根拠に基づいてアクションを起こしましょう。
実行計画 (EXPLAIN) の読み解き方
SQLの実行効率を調査する最強の武器は EXPLAIN コマンドです。
EXPLAIN SELECT name FROM users WHERE email = 'example@test.com';実行結果には、データの読み取り方式が表示されます。
- Full Table Scan (ALL): テーブル全体を端から読み取っている状態。データ量に比例して遅くなるため、改善が必要です。
- Index Scan (index/range): インデックスを利用して範囲を絞り込めている状態。
- Const / Eq_ref: 主キーなどによる一意な検索。最も高速です。
「type」列が「ALL」になっている重いクエリを見つけることが、最適化の第一歩となります。
スロークエリログの活用
データベース側で一定時間以上かかったSQLを記録する「スロークエリログ」を有効にすることも重要です。
これにより、本番環境で実際にユーザーの待ち時間を増やしている「真のボトルネック」を特定できます。
開発環境では再現しにくい、データ量の偏りによる速度低下を可視化できるのが大きなメリットです。
高度な最適化手法:さらに一歩先へ
基本的な最適化を終えた後、さらなる高みを目指すための手法を紹介します。
マテリアライズドビューの検討
集計処理のように、発行のたびに膨大な計算が必要なクエリについては、計算結果を物理的に保存しておく「マテリアライズドビュー」が有効です。
リアルタイム性は若干失われるものの、SQL発行時の計算コストをゼロに近づけることができます。
垂直・水平分割 (シャーディング)
単一のテーブルが巨大になりすぎた場合、テーブルを機能単位で分けたり (垂直分割)、IDの範囲などで複数の物理サーバーに分散させたり (水平分割/シャーディング) することで、1回あたりのSQL発行が対象とするデータ範囲を物理的に縮小します。
読み書き分離 (レプリケーション)
参照用クエリと更新用クエリの発行先を分けるアーキテクチャです。
参照専用のレプリカを複数用意することで、読み取り負荷の高いシステムでもSQL発行の並列性能を高めることが可能です。
まとめ
SQL発行の最適化は、単に「速いクエリを書く」ことだけではありません。
データベースの内部プロセスを理解し、オプティマイザが効率的に動ける環境を整えること、そしてアプリケーション層での無駄な発行を削減することの積み重ねです。
特に以下の3点は、どのようなプロジェクトでも常に意識すべきポイントです。
- バインド変数を使用してパースコストを下げ、セキュリティを高める。
- 実行計画 (EXPLAIN) を確認し、適切なインデックスが貼られているか検証する。
- ORMを使用する際は N+1問題 に注意し、SQLの発行回数自体を最小化する。
パフォーマンス改善に終わりはありませんが、正しい知識に基づいたSQL発行を心がけることで、スケーラブルで堅牢なシステムを構築できるようになります。
データ量の増加を恐れるのではなく、統計情報と実行計画を味方につけ、最適なデータベースアクセスを実現しましょう。