
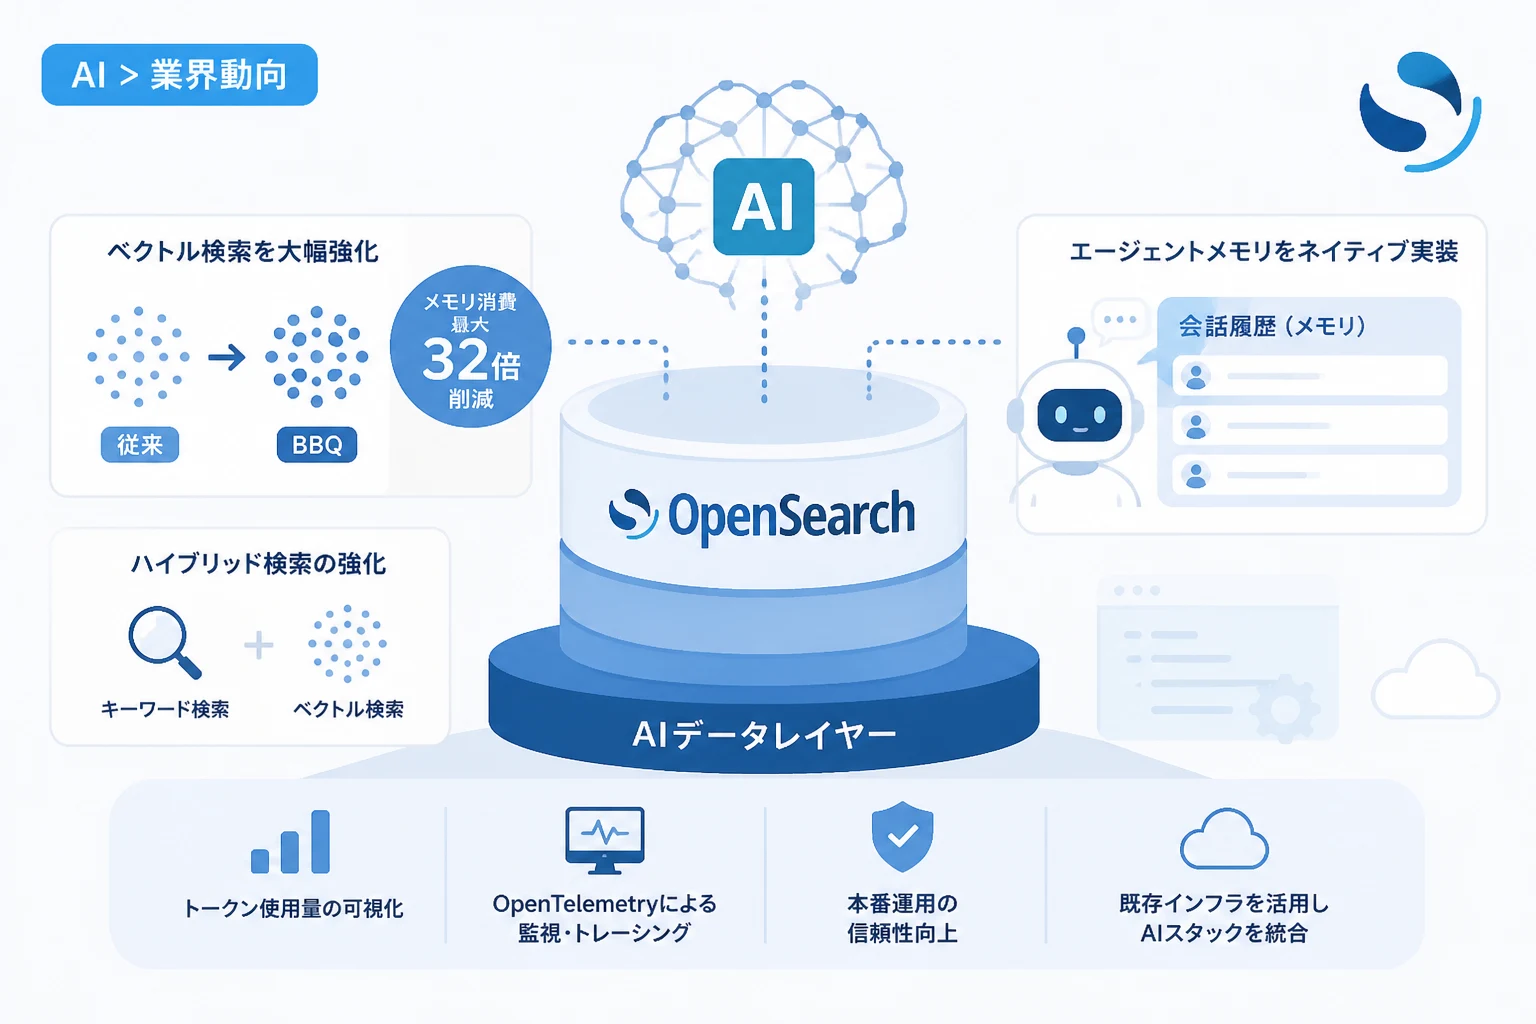
かつてログ分析や全文検索のデファクトスタンダードとして普及したOpenSearchは、今、その役割を劇的に変えようとしています。
生成AIの急速な普及に伴い、開発現場ではセマンティック検索やAIエージェントの会話メモリといった、新たなデータ管理要件が急増しています。
こうしたニーズに応えるべく、2026年に入りリリースされたOpenSearch 3.5および3.6は、単なる検索エンジンを超え、AIアプリケーションの基盤となる「AIデータレイヤー」への進化を決定づけるものとなりました。
既存のインフラを活用しながら、最新のAIスタックを統合しようとするエンジニアにとって、これらのアップデートは無視できない大きな転換点です。
ベクトル検索の進化:精度と効率の両立
AI検索の根幹を支えるベクトル検索において、OpenSearch 3.6は劇的な進化を遂げました。
これまでのベクトル検索は、メモリ消費の激しさが運用上の大きな課題となっていましたが、最新バージョンではその常識が覆されています。
高密度ベクトル検索とBBQによる32倍の圧縮
多くの開発チームが最初に手にするのは、近似最近傍探索 (ANN) を実現するknn_vectorです。
OpenSearch 3.6では、Luceneプロジェクトから統合されたBetter Binary Quantization (BBQ)が導入されました。
BBQは、RaBitQアルゴリズムから派生した量子化手法を用いて、高次元の浮動小数点ベクトルをコンパクトなバイナリ表現に圧縮します。
この技術の驚異的な点は、メモリフットプリントを最大32倍削減しながら、極めて高い検索精度を維持していることです。
例えば、Cohere-768-1Mデータセットを用いたテストでは、従来のFaissバイナリ量子化の再現率が0.30であったのに対し、BBQは0.63を記録しています。
さらにオーバーサンプリングと再スコアリングを組み合わせることで、大規模な本番環境データセットでも0.95を超える再現率を実現しています。
プロジェクト側は将来的にこの32倍圧縮をデフォルト設定にする方針を示しており、開発者が手動でチューニングを行う手間は大幅に軽減されるでしょう。
疎ベクトル検索とSEISMICアルゴリズム
一方で、密度が高い(Dense)ベクトル検索だけでは、製品型番や特定の専門用語といった「正確な一致」を求めるクエリに弱いという側面がありました。
これを補うのがsparse_vectorです。
OpenSearch 3.6では、ニューラル疎検索のためのSEISMICアルゴリズムが導入されました。
これにより、フルインデックススキャンを行うことなく、大規模な疎ベクトル検索が可能になります。
| 検索タイプ | 特徴 | 適したユースケース |
|---|---|---|
| 高密度ベクトル (Dense) | 意味的な文脈や概念を理解する | 曖昧な質問、画像検索、翻訳検索 |
| 疎ベクトル (Sparse) | キーワードの重要性と単語の重みを重視 | 専門用語、型番、特定の固有名詞 |
| ハイブリッド検索 | 上記二つの結果を統合してランク付け | 汎用的なAI検索、RAGアプリケーション |
現在のAIアプリケーション開発のベストプラクティスは、これらを組み合わせたハイブリッド検索です。
OpenSearchは、一つのプラットフォーム内でこれらを高度に融合させるための最適解を提供しています。
AIエージェントの「記憶」をネイティブに管理
これまで、マルチターンの会話を行うAIエージェントを構築する際、開発者は「会話履歴(メモリ)」の管理に苦労してきました。
セッション情報を外部のデータベースに保存し、アプリケーションロジック側でコンテキストを管理する必要があったからです。
ML Commonsによるエージェントメモリの統合
OpenSearch 3.5以降、このエージェントメモリの問題がプラットフォーム側で解決されました。
ML Commonsに直接組み込まれたメモリ管理機能により、フックベースのコンテキスト管理が可能になりました。
開発者は、エージェントセッション中にメモリをどのように保存し、取得し、スコープを定めるかをOpenSearch側で制御できます。
さらに3.6では、新しいセマンティックおよびハイブリッド検索APIを介して、エージェントが過去の記憶を検索できるようになりました。
これにより、単に「直近の数ラリー」を記憶するだけでなく、数日前の会話の中から関連性の高いコンテキストをベクトル類似度やキーワード一致で引き出すことが可能になります。
V2 Chat AgentとUIの統合
新しく構築されたV2 Chat Agentインターフェースは、ツール利用やメモリ統合を維持しつつ、よりクリーンなワークフローを提供します。
また、OpenSearch Dashboardsには永続的な会話履歴機能が追加され、バックエンドのML Commons APIとシームレスに連携します。
これにより、エンジニアはメモリ基盤を一から構築することなく、高度なAI体験の実装に集中できるようになりました。
本番環境での運用性を高める「見えない」改善
AI機能を動かすだけなら簡単ですが、それを商用環境で安定稼働させるのは容易ではありません。
OpenSearch 3.6は、コスト管理と信頼性の面でも重要なアップデートを含んでいます。
トークン使用量の追跡とコスト可視化
AIエージェントの運用において最も懸念されるのが、LLM(大規模言語モデル)のAPIコストです。
OpenSearch 3.6のML Commonsフレームワークには、トークン使用量の自動トラッキング機能が搭載されました。
- Amazon Bedrock (Converse API)
- OpenAI v1
- Gemini v1beta
これらのモデル呼び出しにおいて、設定不要でトークン数が集計されます。
どのステップで、どのモデルが、どれだけのコストを消費したかを可視化できるため、「AIがどこで予算を浪費しているか」を即座に特定できます。
非同期暗号化リファクタリングによる信頼性向上
目立たないながらも重要なのが、暗号化処理の改善です。
従来のEncryptorImplはブロッキング処理を含んでいたため、高負荷なマルチテナント環境においてスレッドの競合や、マスターキー生成のレースコンディションを引き起こすリスクがありました。
最新のアップデートでは、ActionListenerベースの非同期アプローチに刷新され、リクエストをキューイングして処理する仕組みに変わりました。
これにより、高スループットな環境下での断続的なエラーが解消され、エンタープライズレベルの堅牢性が確保されています。
OpenTelemetry標準に基づいた可観測性
デバッグの難しさも改善されました。
OpenSearchはOpenTelemetry (OTel)標準を採用したアプリケーションパフォーマンスモニタリング (APM) を導入しました。
- 分散トレースによるエージェント実行の可視化
- REDメトリクス (Rate, Errors, Duration) の収集
- サービスマップとSLOトラッキング
これまでブラックボックスになりがちだったAIエージェントの内部挙動が、標準的な監視ダッシュボード上で手に取るようにわかるようになります。
OpenSearchが目指す未来:Model Context Protocol (MCP) の採用
OpenSearch 3.6における最も野心的な試みの一つが、Model Context Protocol (MCP)への対応を視野に入れた「opensearch-agent-server」の導入です。
MCPは、AIシステムが外部ツールやデータソースと通信するための標準規格として急速に普及しています。
このプロトコルの採用は、OpenSearchが単なるデータの「貯蔵庫」ではなく、AIエコシステムにおけるアクティブな参加者になろうとしていることを示しています。
データレイヤーそのものがエージェントのツールとして機能し、他のAIサービスとシームレスに連携する世界を見据えているのです。
まとめ
OpenSearch 3.5および3.6のアップデートを俯瞰すると、一つの明確な意志が感じられます。
それは、OpenSearchがもはや「Elasticsearchの代替品」ではなく、AIアプリケーション構築のための究極のデータ基盤(AI Data Layer)を目指しているということです。
BBQによる圧倒的なメモリ効率、疎密両方の検索を統合したハイブリッド検索、そしてプラットフォームにネイティブ統合されたエージェントメモリ。
これらは、現在のAI開発者が直面している課題への直接的な回答です。
ログ分析や検索エンジンとして既にOpenSearchを運用している組織にとって、今あるインフラをそのまま最新のAIスタックへとアップグレードできるメリットは計り知れません。
OpenSearchは、次世代のAIアプリケーションを支える、最も有力な選択肢となったと言えるでしょう。