
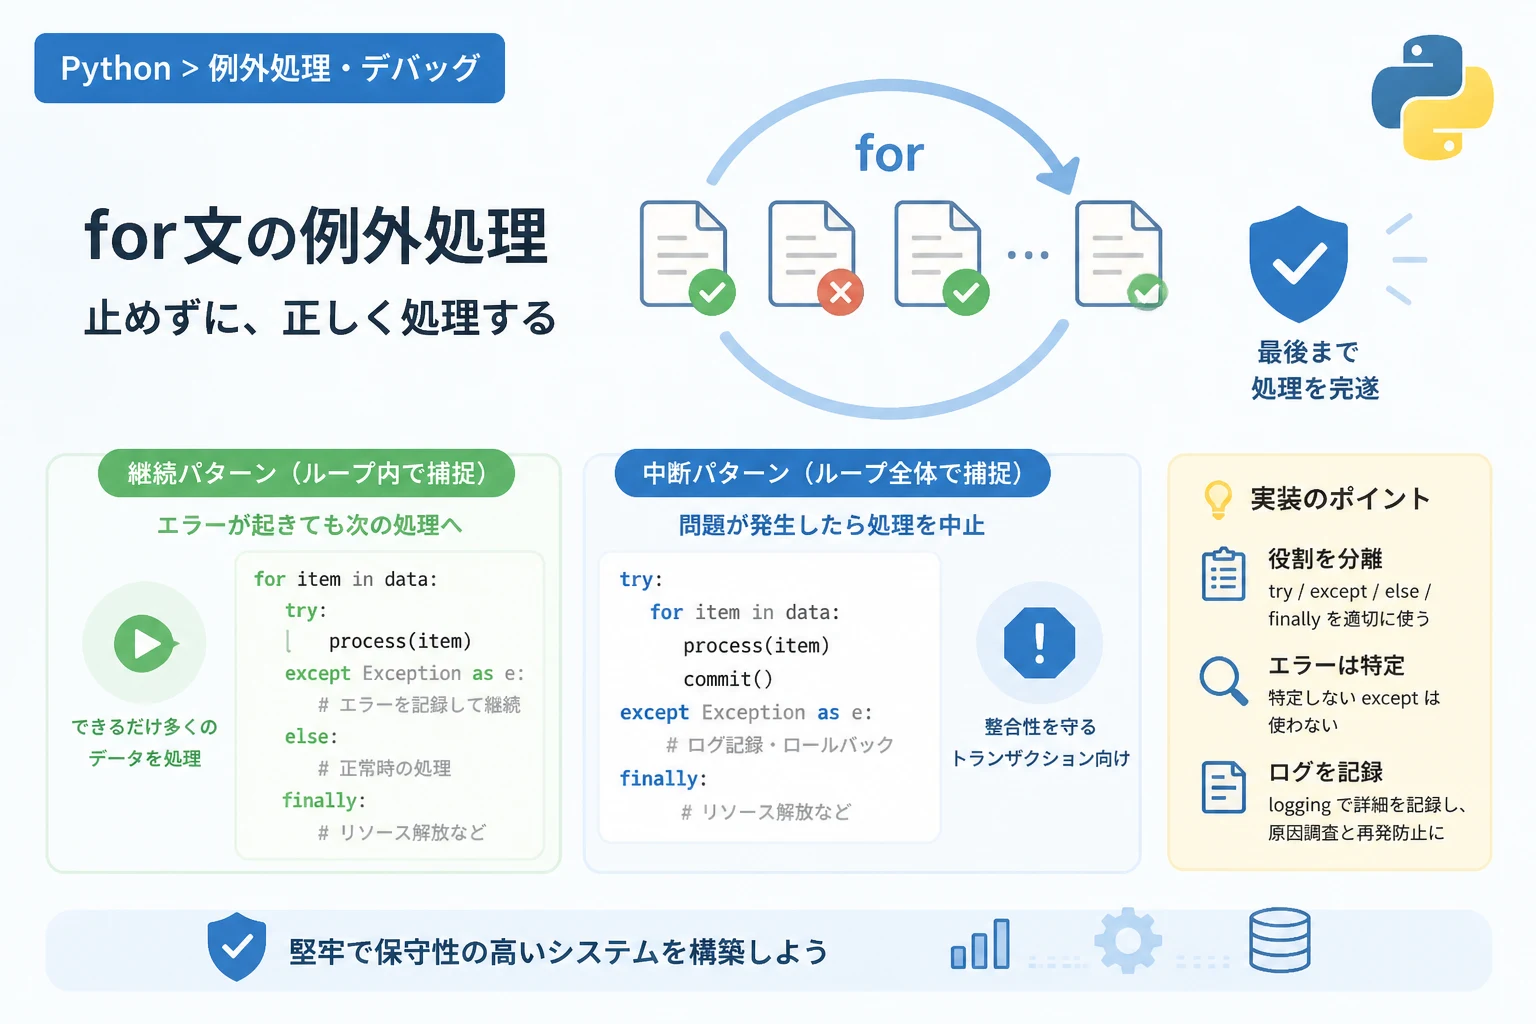
Pythonで大量のデータを処理したり、外部APIと連携したりする際、避けて通れないのが例外(エラー)の発生です。
特にfor文を用いたループ処理において、一つのエラーでプログラム全体が停止してしまうことは、実務上の大きな課題となります。
数千件のデータのうち、たった1件のフォーマット不備で処理が中断されるのは非効率です。
この記事では、Pythonのfor文におけるtry-exceptの適切な配置パターンを詳しく解説します。
エラーが発生してもループを止めずに継続する方法から、あえて中断させる判断基準、さらにはエラー内容を正確に記録する実戦的なテクニックまでを網羅しました。
堅牢なPythonプログラムを構築するためのスキルを身につけていきましょう。
なぜループ処理に例外処理が必要なのか
Pythonのプログラムは、実行中にエラーが発生するとその時点で動作を停止し、エラーメッセージを表示します。
これはプログラムのバグを早期に発見するためには有用ですが、本番環境で動作するバッチ処理やデータスクレイピングにおいては、致命的な問題となることがあります。
例えば、10,000件のユーザーデータを順番にデータベースへ登録する処理を考えてみましょう。
9,999件目まで順調に処理が進んでいたとしても、最後の1件で予期せぬデータ形式が含まれていた場合、try-exceptによる適切な処理が行われていなければ、それまでの苦労が水の泡になりかねません。
ループ処理における例外処理の主な目的は、以下の3点に集約されます。
- 継続性:一部のエラーを無視して、残りの正常なデータを最後まで処理する。
- 安全性:エラーが発生した際に、開いているファイルや接続を適切に閉じる。
- 可視性:どのデータで、どのようなエラーが起きたのかをログとして残す。
これらを実現するために、try-exceptをどこに配置すべきかを正しく理解する必要があります。
実装パターン1:ループ内で例外を処理する(継続パターン)
最も一般的で実用的なのが、for文のブロック内部にtry-exceptを配置するパターンです。
この方法を採用すると、特定の繰り返し項目でエラーが発生しても、後続の処理に影響を与えずにループを続行できます。
基本的な構造
まずは、数値のリストを10で割る簡単な例を見てみましょう。
リストの中に「0」が含まれていると、ZeroDivisionErrorが発生しますが、ループ内で処理すれば他の計算は継続されます。
numbers = [2, 5, 0, 10, 4]

for num in numbers:
    try:
        # 例外が発生する可能性がある処理
        result = 10 / num
        print(f"10 / {num} = {result}")
    except ZeroDivisionError:
        # エラーが発生した時の対処
        print(f"エラー:{num} での除算はできません。スキップします。")

print("すべての処理が完了しました。")10 / 2 = 5.0
10 / 5 = 2.0
エラー:0 での除算はできません。スキップします。
10 / 10 = 1.0
10 / 4 = 2.5
すべての処理が完了しました。このように、エラーが発生した項目だけがスキップされ、最後まで処理が実行されていることがわかります。
continue文との組み合わせ
エラーが発生した際に、それ以降の処理を飛ばして次のループへ即座に移りたい場合は、except節の中でcontinueを使用します。
これは、tryブロックの中に複数の処理ステップがある場合に非常に有効です。
data_list = ["100", "200", "invalid", "300"]

for data in data_list:
    try:
        # ステップ1: 数値に変換
        value = int(data)

        # ステップ2: 複雑な計算(ここでは単純化)
        processed_value = value * 1.1

        print(f"処理成功: {processed_value}")

    except ValueError:
        print(f"警告: '{data}' は数値ではないためスキップします。")
continue処理成功: 110.0
処理成功: 220.0
警告: 'invalid' は数値ではないためスキップします。
処理成功: 330.0continueを明示的に書くことで、「この項目は失敗したから次へ行く」という意図がコードを読み手に伝わりやすくなります。
実装パターン2:ループ全体を例外処理で囲む(中断パターン)
一方で、for文の外側にtry-exceptを配置するパターンもあります。
これは、一箇所でもエラーが発生した場合、その後のループをすべて中止すべき状況で利用します。
データの整合性を重視する場合
例えば、複数のファイルを一つのアーカイブにまとめる処理や、一連のトランザクション処理などは、途中で失敗すると全体の整合性が崩れる可能性があります。
items = ["file1.txt", "file2.txt", "missing_file.txt", "file3.txt"]

try:
    for item in items:
        print(f"{item} を処理中...")
        # ファイルが存在しない場合にエラーが発生すると仮定
        if item == "missing_file.txt":
            raise FileNotFoundError(f"{item} が見つかりません")
        print(f"{item} の処理が正常に完了しました。")
except FileNotFoundError as e:
print(f"致命的なエラーが発生したため、全体の処理を中止します: {e}")file1.txt を処理中...
file1.txt の処理が正常に完了しました。
file2.txt を処理中...
file2.txt の処理が正常に完了しました。
missing_file.txt を処理中...
致命的なエラーが発生したため、全体の処理を中止します: missing_file.txt が見つかりませんこのパターンでは、missing_file.txt でエラーが発生した瞬間、後続の file3.txt の処理は行われません。
どちらのパターンを選ぶべきか
以下の表に、配置場所による挙動の違いをまとめました。
| 配置場所 | 挙動 | 主な用途 |
|---|---|---|
| ループの内部 | エラーが発生しても次の要素の処理へ進む | データクレンジング、個別ファイルの読み込み、Webスクレイピング |
| ループの外部 | エラーが発生した時点でループ自体が終了する | トランザクション処理、設定ファイルの読み込み、依存関係のある処理 |
基本的には、「個別の失敗が全体に影響するかどうか」を基準に判断しましょう。
try-except-else-finally の完全活用
Pythonの例外処理には、try と except 以外にも else と finally という強力なキーワードがあります。
これらをループ内で使いこなすことで、より洗練されたコードが書けます。
elseブロックのメリット
else ブロックは、「tryブロックで例外が発生しなかった場合のみ実行される」処理を記述するために使います。
tryブロックの中を最小限に抑えることができるため、コードの可読性が向上し、意図しない例外を捕捉してしまうリスクを減らせます。
for i in range(3):
    try:
        print(f"--- 試行 {i} ---")
        # 例外が発生しうる最小限の処理
        value = i + 1
    except Exception as e:
        print(f"エラー発生: {e}")
    else:
        # 例外が起きなかった時の正常系処理
        print(f"計算に成功しました。結果: {value}")
finallyブロックによるリソース解放
finally ブロックは、「例外の有無にかかわらず、必ず最後に実行される」処理です。
ループ内でファイルを開いたり、データベース接続を行ったりする場合の後始末に最適です。
import random

for i in range(3):
    print(f"セッション {i} 開始")
    try:
        if random.random() < 0.5:
            raise RuntimeError("通信エラー")
        print("通信成功")
    except RuntimeError as e:
        print(f"補足されたエラー: {e}")
    finally:
        # 成功しても失敗しても必ずクローズ処理を行う
        print("ネットワーク接続を終了します")
実践的な活用シーン:データクレンジング
現実のプロジェクトでは、リスト内の辞書データを処理するような場面が多々あります。
ここでは、一部のデータにキーが欠落していたり、型が異なっていたりする場合の堅牢な実装例を紹介します。
users = [
    {"name": "Alice", "age": 25},
    {"name": "Bob", "age": "不明"},  # 型エラー候補
    {"name": "Charlie"},            # キー欠落候補
    {"name": "Dave", "age": 30}
]

parsed_ages = []

for user in users:
    try:
        name = user["name"]
        # int変換でエラーの可能性がある
        age = int(user["age"])
    except KeyError:
        print(f"エラー: {user.get('name', 'Unknown')} の年齢データが存在しません。")
    except ValueError:
        print(f"エラー: {user.get('name')} の年齢 '{user.get('age')}' が数値ではありません。")
    except Exception as e:
        print(f"予期せぬエラーが発生しました: {e}")
    else:
        parsed_ages.append(age)
        print(f"{name} さんのデータを正常に処理しました。")

print(f"処理完了。有効な年齢リスト: {parsed_ages}")Alice さんのデータを正常に処理しました。
エラー: Bob の年齢 '不明' が数値ではありません。
エラー: Charlie の年齢データが存在しません。
Dave さんのデータを正常に処理しました。
処理完了。有効な年齢リスト: [25, 30]このように、例外の種類ごとに処理を分けることで、何が原因でデータが処理できなかったのかを明確に特定できます。
アンチパターン:避けるべき実装方法
例外処理を記述する際、陥りやすい罠がいくつかあります。
これらを避けるだけで、コードの品質は格段に向上します。
1. 裸のexcept(Bare except)
以下のようなコードは極力避けてください。
# NG例
try:
    process_data()
except:
    pass
これは SystemExit や KeyboardInterrupt(Ctrl+Cによる停止)まで捕捉してしまうため、プログラムが強制終了できなくなるなどの予期せぬ挙動を招きます。
必ず except Exception: と書くか、具体的な例外クラスを指定しましょう。
2. 例外の握りつぶし
エラーが発生した際に、何も記録せずに pass してしまうのは危険です。
# 危険な例
for item in heavy_data:
    try:
        save_to_db(item)
    except:
        pass  # 何が起きたか分からなくなる
後で「なぜかデータが足りない」となった際、原因究明が不可能になります。
最低限、エラー内容をプリントするか、ログファイルに出力するようにしましょう。
エラー内容のロギング(loggingモジュールの活用)
商用環境で動作させるスクリプトの場合、print ではなく logging モジュールを使用するのが標準的です。
import logging

# ログの設定
logging.basicConfig(level=logging.ERROR, filename='error.log')

data_list = [10, "a", 20]

for item in data_list:
    try:
        result = item * 2
        print(result)
    except Exception as e:
        # スタックトレースを含めてログに記録
        logging.error(f"項目の処理中にエラーが発生しました: {item}", exc_info=True)
これを行うことで、後から error.log を確認し、どの行でどのようなエラーが起きたのかを詳細に追跡できます。
まとめ
Pythonのfor文における例外処理は、プログラムの安定性を左右する重要な技術です。
- 個別の失敗を許容し、処理を続けたい場合は、ループの内側に
try-exceptを配置する。 - 一箇所の失敗が全体に影響する場合は、ループの外側を
try-exceptで囲む。 elseやfinallyを活用して、正常系と異常系の処理を明確に分離する。except Exception as e:を使い、エラー内容を適切にロギングする。
これらのパターンを状況に応じて使い分けることで、途中で止まることのない、信頼性の高いシステムを構築できるようになります。
まずは小規模なスクリプトから、適切な例外処理を組み込む習慣をつけてみてください。