
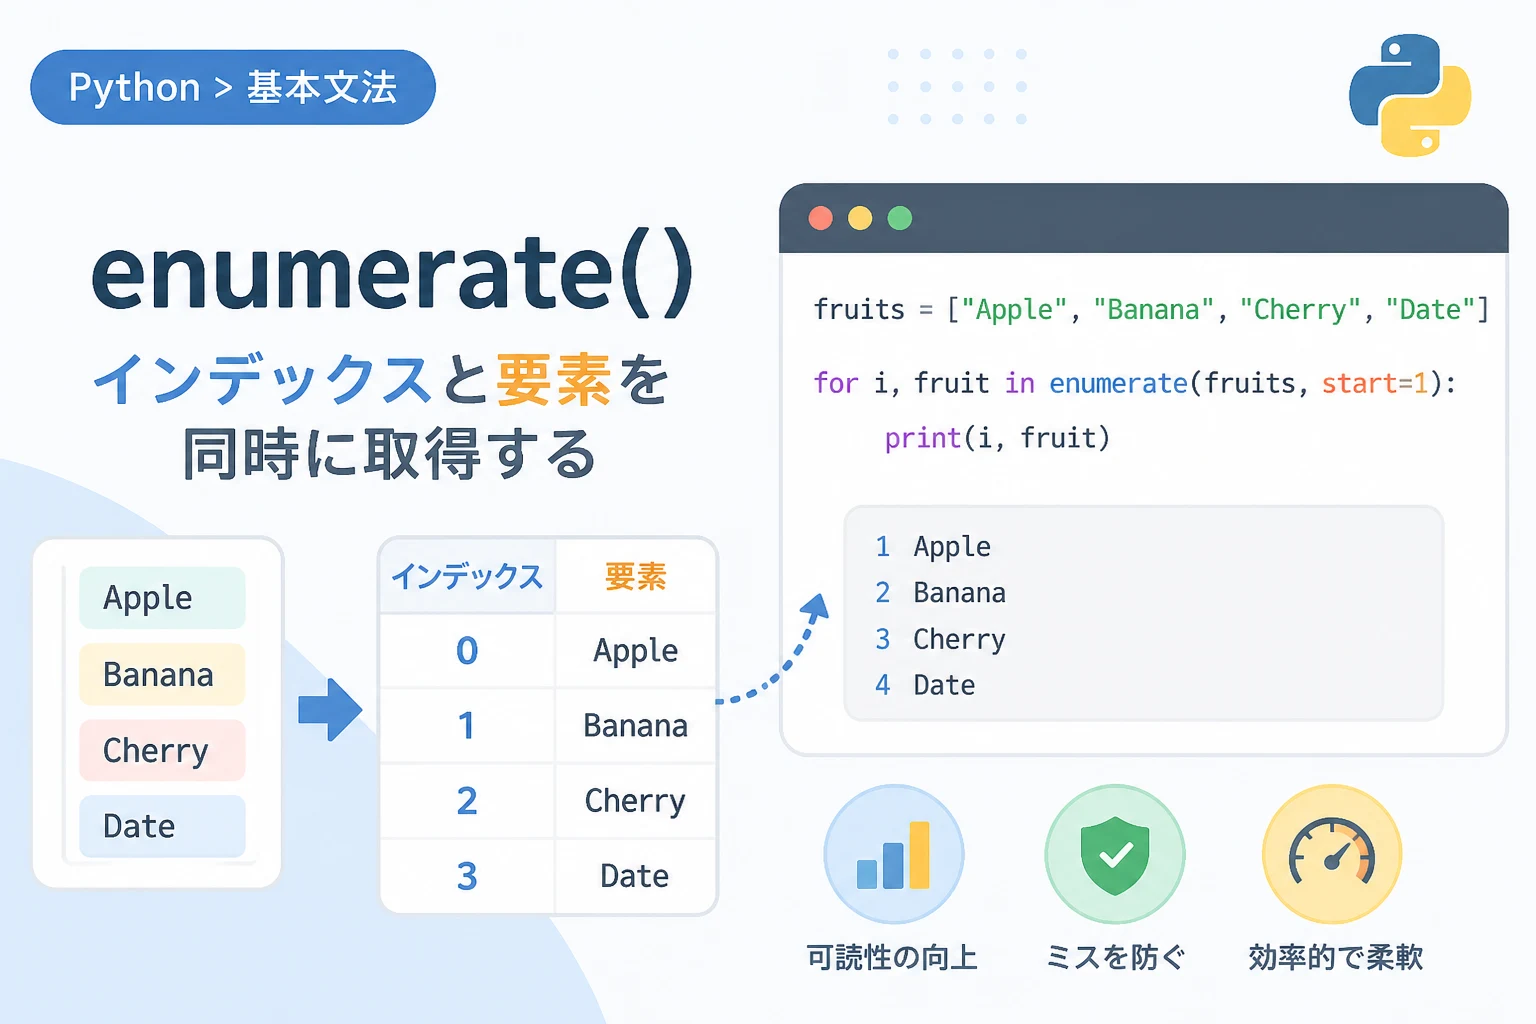
Pythonのプログラミングにおいて、リストやタプルなどのイテラブルなオブジェクトをループ処理する際、現在の要素だけでなく、その要素が何番目にあるのかという「インデックス情報」が必要になる場面は多々あります。
多くのプログラミング言語ではカウンタ変数を用意して手動でインクリメントしますが、Pythonではenumerate関数を使用することで、スマートかつ効率的にインデックスと要素を同時に取得することが可能です。
この記事では、初心者から中級者まで役立つenumerate関数の基本的な使い方から、応用的なテクニック、そしてなぜこの関数が推奨されるのかという理由までを詳しく解説します。
enumerate関数の概要
Pythonのenumerate()は、リスト、タプル、文字列などのイテラブル(反復可能)なオブジェクトを受け取り、インデックスと要素のペアを順に返すイテレータを生成する組み込み関数です。
通常のfor文では要素のみを取り出しますが、enumerateを介することで、わざわざループの外で変数i = 0を定義し、ループ内でi += 1とするような手間を省くことができます。
これにより、コードが簡潔になり、読みやすさ(可読性)が大幅に向上します。
基本的な使い方
まずは、もっとも標準的なenumerateの使い方を確認しましょう。
基本的な構文
enumerate関数の基本的な構文は以下の通りです。
for インデックス, 要素 in enumerate(イテラブルオブジェクト):
    # 処理
具体的なコード例
リストに含まれる果物の名前と、その順序を表示するプログラムを作成してみます。
fruits = ["apple", "banana", "cherry"]

for index, fruit in enumerate(fruits):
print(f"インデックス: {index}, 要素: {fruit}")インデックス: 0, 要素: apple
インデックス: 1, 要素: banana
インデックス: 2, 要素: cherryこのように、enumerateはデフォルトで0から始まるインデックスを自動的に割り当ててくれます。
ループの各ステップで、インデックスと要素がタプルとして返され、それをアンパック(展開)して2つの変数(ここではindexとfruit)に代入しています。
開始番号の指定(start引数)
実務では、インデックスを0からではなく1から始めたい場合や、特定の数値からカウントを開始したい場合があります。
その際に便利なのが、enumerateの第2引数であるstartです。
1から始めたい場合
例えば、ランキングや箇条書きのリストを作成する場合、1番から表示するのが一般的です。
animals = ["dog", "cat", "rabbit"]

# start=1 を指定して、1番からカウントを開始する
for number, animal in enumerate(animals, start=1):
print(f"{number}番目の動物: {animal}")1番目の動物: dog
2番目の動物: cat
3番目の動物: rabbitstart引数に値を渡すだけで、ループ内部の計算処理を変更することなく、開始数値を自由に変更可能です。
これは「101番から開始する」といった特殊なケースでも同様に機能します。
なぜrange(len())ではなくenumerateを使うべきか
Pythonを学び始めたばかりの頃、インデックスを取得するために以下のようなコードを書いてしまうことがあります。
# 非推奨な書き方
data = ["A", "B", "C"]
for i in range(len(data)):
    value = data[i]
print(i, value)しかし、Pythonの設計思想(Pythonic)においては、enumerateの使用が強く推奨されます。
その理由は主に3つあります。
1. 可読性の向上
range(len(data))を使用すると、まずデータの長さを取得し、その範囲の数値を生成し、さらにその数値を使ってリストから要素を検索するという3段階の手順を踏んでいます。
一方、enumerateは「インデックスと要素を同時に取り出す」という意図が明確であり、コードを一目見ただけで何をしているかが伝わります。
2. メンテナンス性と安全性の確保
data[i]のようにインデックスを使って要素にアクセスする方法は、リストの構造が複雑になったり、ループ内でリストを操作したりする場合にバグの原因となりやすいです。
特に多重ループなどで変数名が複雑になると、間違ったインデックスを指定してしまうリスクがあります。
enumerateを使えば、要素は直接変数に格納されるため、インデックス指定ミスによるエラーを防ぐことができます。
3. パフォーマンスとメモリ効率
enumerateはイテレータを返します。
これは、すべての要素とインデックスを一度にメモリ上に展開するのではなく、必要になったタイミングで一つずつ生成する仕組みです。
そのため、非常に大きなデータを扱う場合でも、メモリ消費を最小限に抑えることができます。
| 比較項目 | range(len()) | enumerate() |
|---|---|---|
| 可読性 | 低い(冗長) | 高い(簡潔) |
| 安全性 | インデックスミスの恐れあり | 安全(直接取得) |
| 推奨度 | 非推奨 | 強く推奨 |
実践的な活用シーン
enumerateは単純な出力以外にも、さまざまな場面で活用できます。
条件に一致する要素のインデックスを特定する
特定の条件を満たす要素がリストのどこにあるかを知りたい場合に有効です。
scores = [85, 42, 98, 55, 76, 30]
failed_indices = []

for index, score in enumerate(scores):
    if score < 50:
        failed_indices.append(index)

print(f"赤点のインデックス: {failed_indices}")赤点のインデックス: [1, 5]特定の周期で処理を切り替える
インデックスを数値として扱えるため、剰余演算子%と組み合わせて、「3回に1回だけ特別な処理をする」といった制御が簡単に行えます。
tasks = ["Task1", "Task2", "Task3", "Task4", "Task5", "Task6"]

for i, task in enumerate(tasks, start=1):
    print(f"処理中: {task}")
    if i % 3 == 0:
print("--- 休憩(3タスク完了) ---")処理中: Task1
処理中: Task2
処理中: Task3
--- 休憩(3タスク完了) ---
処理中: Task4
処理中: Task5
処理中: Task6
--- 休憩(3タスク完了) ---ファイルの読み込みと行番号の表示
テキストファイルを1行ずつ読み込みながら、エラー箇所を特定するために行番号を表示したい場合などに便利です。
# ファイル読み込みのシミュレーション
lines = ["Python", "Enumerate", "Tutorial", "Example"]

for line_num, content in enumerate(lines, start=1):
    print(f"L{line_num}: {content}")
複数のリストを同時に扱う(zipとの併用)
複数のリストを同時にループさせつつ、インデックスも取得したい場合は、zip関数と組み合わせることができます。
names = ["Alice", "Bob", "Charlie"]
ages = [25, 30, 35]

for i, (name, age) in enumerate(zip(names, ages), start=1):
print(f"{i}人目: {name}さんは{age}歳です。")1人目: Aliceさんは25歳です。
2人目: Bobさんは30歳です。
3人目: Charlieさんは35歳です。ここで注意すべき点は、enumerateが返すのは「インデックス」と「zipが返したタプル」であるため、for i, (name, age)のようにカッコを使って適切にアンパックする必要があることです。
注意点とよくある間違い
便利で強力なenumerateですが、使いこなす上で注意が必要なポイントもあります。
引数の順番を間違えない
もっとも多いミスは、for文での受け取り順序を「要素, インデックス」と勘違いしてしまうことです。
enumerateは必ず「(インデックス, 要素)」の順番で値を返します。
# 間違った例
for item, index in enumerate(my_list):
    # itemの中に数値(インデックス)が入ってしまい、意図しない動作になる
もし逆の順番で受け取りたい場合は、変数の名前を適切に付けることでミスを防ぎましょう。
enumerateオブジェクト自体の性質
enumerate(data)を実行して返ってくるのは、リストではなく「enumerateオブジェクト」です。
中身を一度に見たい場合は、list()関数でリストに変換する必要があります。
data = ["a", "b"]
obj = enumerate(data)
print(obj) # <enumerate object at 0x...>
print(list(obj)) # [(0, 'a'), (1, 'b')]ただし、通常はfor文の中でそのまま使うため、この性質を意識して明示的に変換する必要はありません。
まとめ
Pythonのenumerate関数は、ループ処理においてインデックスと要素を同時に扱うための、もっとも美しく効率的な手段です。
- インデックスと要素を同時に取得できるため、コードが簡潔になる。
start引数を使えば、任意の数値からカウントを開始できる。range(len())よりも可読性と安全性が高く、Pythonのコーディング規約にも適している。- メモリ効率が良いイテレータとして動作するため、大規模データの処理にも向いている。
これまで手動でカウンタ変数を用意していたり、複雑なインデックス指定を行っていたりした方は、ぜひ今日からenumerateを活用してみてください。
この一歩が、より「Pythonらしい」洗練されたコードを書くための大きな助けとなるはずです。