
C言語でシステム開発や組み込みプログラミングを行う際、データの集合体である構造体の扱いは避けて通れません。
複数の異なる型をひとまとめにする構造体は非常に便利ですが、その「コピー」に関しては、初学者が陥りやすい罠や、ベテランエンジニアでも設計時に慎重になるべきポイントが多々あります。
単に値を複製するだけのように思えますが、メモリレイアウトやポインタの有無、そしてパフォーマンスへの影響を考慮しなければ、バグの温床となりかねません。
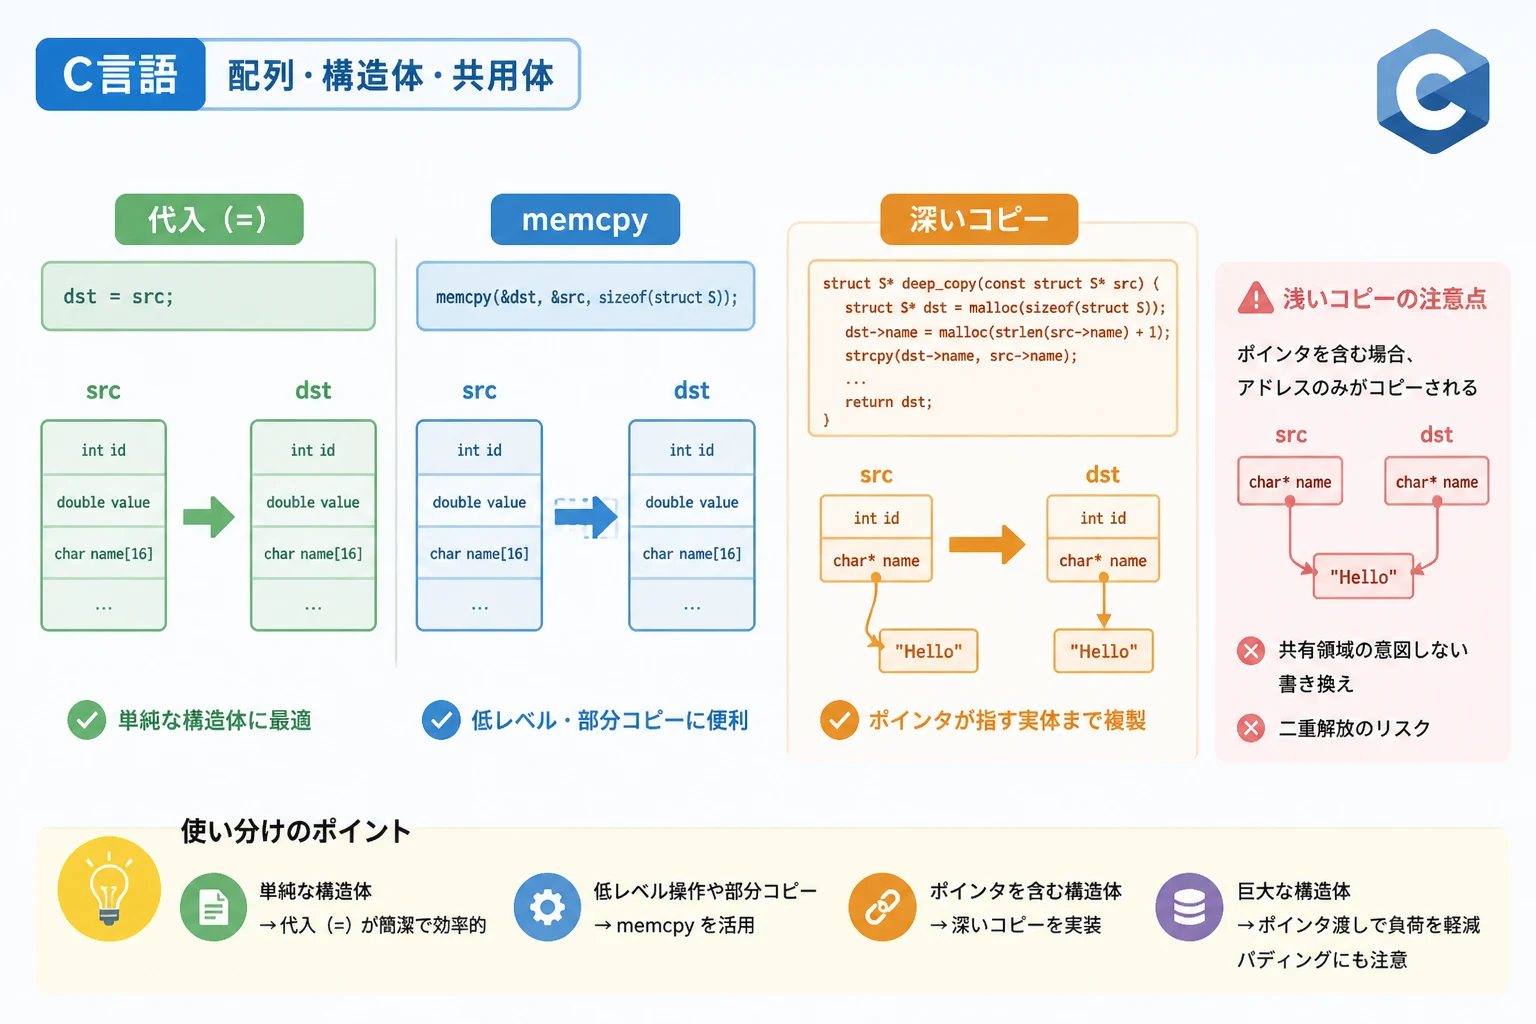
本記事では、2026年現在の標準的な開発手法に基づき、構造体コピーの基本的な代入から、memcpyを用いた手法、さらに複雑な「深いコピー」の設計指針までを詳しく解説します。
構造体コピーの基本:代入演算子による単純コピー
C言語において、同じ型の構造体変数同士であれば、代入演算子(=)を用いて一括でコピーを行うことが可能です。
これは最もシンプルで直感的な方法であり、コンパイラが構造体のサイズに合わせて最適化されたコピー処理を生成してくれます。
代入演算子の挙動
構造体変数を別の構造体変数に代入すると、構造体に含まれるすべてのメンバが、メモリ上のビット列としてそのままコピーされます。
これには基本データ型(int, floatなど)だけでなく、構造体内に含まれる固定長配列も含まれます。
#include <stdio.h>
#include <string.h>

// 構造体の定義
struct Student {
    int id;
    char name[32];
    double score;
};

int main() {
    // 初期化
    struct Student alice = {1, "Alice", 85.5};
    struct Student clone;

    // 代入演算子によるコピー
    clone = alice;

    // 結果の確認
    printf("Clone ID: %d\n", clone.id);
    printf("Clone Name: %s\n", clone.name);
    printf("Clone Score: %.1f\n", clone.score);

    // 元のデータを変更してもコピー先には影響しない
    alice.id = 99;
    printf("Alice ID changed to: %d, Clone ID remains: %d\n", alice.id, clone.id);

    return 0;
}Clone ID: 1
Clone Name: Alice
Clone Score: 85.5
Alice ID changed to: 99, Clone ID remains: 1この方法の利点は、コードが非常に読みやすく、型安全性が保たれる点にあります。
また、メンバが一つずつコピーされるのではなく、メモリブロックとして効率的に処理されるため、多くの場合で十分なパフォーマンスを発揮します。
固定長配列の扱い
C言語の配列そのものは代入演算子でコピーできませんが、構造体のメンバとして定義された固定長配列は、構造体ごとの代入によって丸ごとコピーされます。
これは、構造体という枠組みが配列を一つの値としてカプセル化しているためです。
上記のサンプルコードで name 配列が正しくコピーされているのはこの性質によるものです。
memcpy関数を用いたメモリブロックとしてのコピー
標準ライブラリの <string.h> に含まれる memcpy 関数を使用する方法は、より低レベルなメモリ操作を伴います。
代入演算子によるコピーと本質的には似ていますが、特定の状況下では memcpy が好まれる、あるいは必要とされることがあります。
memcpyの基本構文
memcpy は、指定されたバイト数分だけメモリの内容を転送します。
構造体のコピーにおいては、sizeof 演算子を組み合わせて使用するのが一般的です。
#include <stdio.h>
#include <string.h>

struct Config {
    int mode;
    long timeout;
    char flags[8];
};

int main() {
    struct Config source = {2, 5000, {1, 0, 1, 0, 1, 1, 0, 0}};
    struct Config destination;

    // memcpyによるコピー
    memcpy(&destination, &source, sizeof(struct Config));

    printf("Destination Mode: %d, Timeout: %ld\n", destination.mode, destination.timeout);

    return 0;
}Destination Mode: 2, Timeout: 5000memcpyを選択すべき場面
現代のコンパイラでは、単純な代入も memcpy も同等の最適化が行われることが多いですが、以下のようなケースでは memcpy が意識的に使われます。
- 部分的なコピー:構造体全体ではなく、特定のオフセットから特定のサイズだけをコピーしたい場合。
- バイト配列との相互変換:シリアライズ処理などで、構造体のデータを
unsigned char配列などに転送する場合。 - ジェネリックな処理:コピー対象の型がコンパイル時に確定せず、ポインタとサイズのみが渡される関数内でコピーを行う場合。
ただし、memcpy を使用する際は、コピー元とコピー先のメモリ領域が重なっていないことを保証する必要があります。
領域が重なる可能性がある場合は、より安全な memmove を使用してください。
浅いコピー(Shallow Copy)の限界と危険性
ここまで紹介した「代入演算子」と memcpy は、いずれも浅いコピー(Shallow Copy)と呼ばれる手法です。
これは、構造体のメンバの値をそのまま写し取るだけの処理です。
構造体のメンバに「ポインタ」が含まれている場合、この浅いコピーが深刻な問題を引き起こします。
ポインタが含まれる構造体のコピー例
以下のコードを見てください。
#include <stdio.h>
#include <stdlib.h>
#include <string.h>

struct Book {
    char *title;
    int pages;
};

int main() {
    struct Book b1;
    b1.pages = 200;
    b1.title = (char *)malloc(32);
    strcpy(b1.title, "C Programming");

    // 浅いコピー
    struct Book b2 = b1;

    printf("b1.title: %s, Address: %p\n", b1.title, (void*)b1.title);
    printf("b2.title: %s, Address: %p\n", b2.title, (void*)b2.title);

    // b1.titleの内容を変更すると...
    strcpy(b1.title, "Updated Title");

    printf("Modified b1.title: %s\n", b1.title);
    printf("Effect on b2.title: %s\n", b2.title);

    free(b1.title);
    // free(b2.title); // 二重解放(Double Free)の危険!

    return 0;
}b1.title: C Programming, Address: 0x55...
b2.title: C Programming, Address: 0x55...
Modified b1.title: Updated Title
Effect on b2.title: Updated Titleこの結果からわかるように、b2 = b1 によってコピーされたのは「文字列の内容」ではなく「文字列が格納されているメモリのアドレス(ポインタ値)」だけです。
その結果、b1とb2が同じメモリ領域を指してしまい、一方を変更するともう一方も変わってしまいます。
また、最後に free を行う際、同じアドレスを二回解放しようとしてプログラムがクラッシュする原因になります。
深いコピー(Deep Copy)の実装手法
ポインタが指し示す先のデータまで含めて完全に複製することを深いコピー(Deep Copy)と呼びます。
C言語にはこれを自動で行う仕組みはないため、開発者が明示的にロジックを記述する必要があります。
深いコピーの基本手順
深いコピーを実現するには、以下の手順を踏みます。
- コピー先の構造体変数を準備する。
- ポインタ以外のメンバ(数値など)をコピーする。
- コピー先のポインタメンバに対して、
malloc等で新しいメモリ領域を割り当てる。 - コピー元のポインタが指す内容を、新しく割り当てた領域にコピーする。
実装例:コピー専用関数の作成
構造体の設計時に、その構造体専用のコピー関数(あるいはクローン関数)を用意するのがベストプラクティスです。
#include <stdio.h>
#include <stdlib.h>
#include <string.h>

struct Document {
    int id;
    char *content;
};

// 深いコピーを行う関数
int copy_document(struct Document *dest, const struct Document *src) {
    if (dest == NULL || src == NULL) return -1;

    dest->id = src->id;

    if (src->content != NULL) {
        // メモリを新規確保
        dest->content = (char *)malloc(strlen(src->content) + 1);
        if (dest->content == NULL) return -1;
        // 内容をコピー
        strcpy(dest->content, src->content);
    } else {
        dest->content = NULL;
    }

    return 0;
}

// 解放用関数
void free_document(struct Document *doc) {
    if (doc->content != NULL) {
        free(doc->content);
        doc->content = NULL;
    }
}

int main() {
    struct Document doc1 = {101, "Original Content"};
    struct Document doc2;

    if (copy_document(&doc2, &doc1) == 0) {
        printf("doc1 content: %s\n", doc1.content);
        printf("doc2 content: %s\n", doc2.content);

        // doc1を書き換えてもdoc2には影響しない
        doc1.content[0] = 'X';
        printf("Modified doc1: %s\n", doc1.content);
        printf("Independent doc2: %s\n", doc2.content);

        free_document(&doc2);
    }

    return 0;
}doc1 content: Original Content
doc2 content: Original Content
Modified doc1: Xriginal Content
Independent doc2: Original Content深いコピーを適切に実装することで、各構造体インスタンスが完全に独立した状態を保つことができ、メモリ管理の安全性(特に free のタイミング)が飛躍的に向上します。
パフォーマンスとコピーのオーバーヘッド
構造体のコピーは便利ですが、サイズが極端に大きい構造体(数キロバイトを超えるようなもの)を頻繁にコピーすると、実行速度に悪影響を及ぼすことがあります。
値渡しとポインタ渡しの違い
関数に構造体を渡す際、引数としてそのまま渡すと「値のコピー」が発生します。
// 値渡し(構造体全体のコピーが発生)
void process_data(struct LargeStruct s) {
    // 処理
}

// ポインタ渡し(アドレスのコピーのみで済む)
void process_data(const struct LargeStruct *s) {
    // 処理
}読み取り専用の処理であれば、ポインタ渡し(constポインタ)を利用することで、無駄なコピーを回避するのが定石です。
2026年現在の高機能なCPUであっても、数メガバイト単位のメモリコピーをループ内で行えば無視できない遅延となります。
構造体をコピーすべきか、それともポインタで共有すべきかは、データの所有権(Ownership)の観点から設計する必要があります。
構造体コピーにおけるアライメントとパディングの注意点
memcpy や代入演算子を使用する際、意識しておくべきなのが構造体のパディングです。
C言語の構造体は、CPUのアクセス効率を高めるために、メンバ間に「詰め物(パディング)」が挿入されることがあります。
| メンバ名 | 型 | サイズ(例) | オフセット |
|---|---|---|---|
| id | char | 1 byte | 0 |
| (padding) | – | 3 bytes | 1 |
| value | int | 4 bytes | 4 |
このように、実際のデータサイズよりも構造体全体の sizeof が大きくなることが一般的です。
代入演算子や memcpy は、このパディング部分も含めてコピーします。
通常は問題になりませんが、構造体の内容をハッシュ値計算に回したり、ネットワーク越しに送信したりする場合、パディング部分に未初期化のゴミデータが入っていると、同じデータ内容でも比較結果が異なると判定されるリスクがあります。
これを防ぐためには、構造体を使用する前に memset で全体をゼロクリアしておくことが推奨されます。
まとめ
C言語における構造体のコピーは、対象となるデータの性質によって最適な手法が異なります。
- 単純な構造体(ポインタなし):可読性の高い代入演算子(=)を使用するのが最適です。
- バイト単位の制御が必要な場合:標準的な
memcpyを使用し、サイズ計算には必ずsizeofを用います。 - ポインタを含む構造体:浅いコピーによる二重解放や意図しない書き換えを防ぐため、必ず深いコピー(Deep Copy)を実装します。
- 巨大な構造体:不要なコピーを避けるため、関数引数などではポインタ渡しを活用します。
構造体のコピーを正しく理解し使い分けることは、C言語プログラミングにおけるメモリ管理の根幹を成す技術です。
まずは自分の扱う構造体が「値」として完結しているのか、それとも「外部リソース(ポインタ)」を管理しているのかを明確に定義することから始めましょう。
適切な手法を選択することで、堅牢で効率的なプログラムを構築できるはずです。