
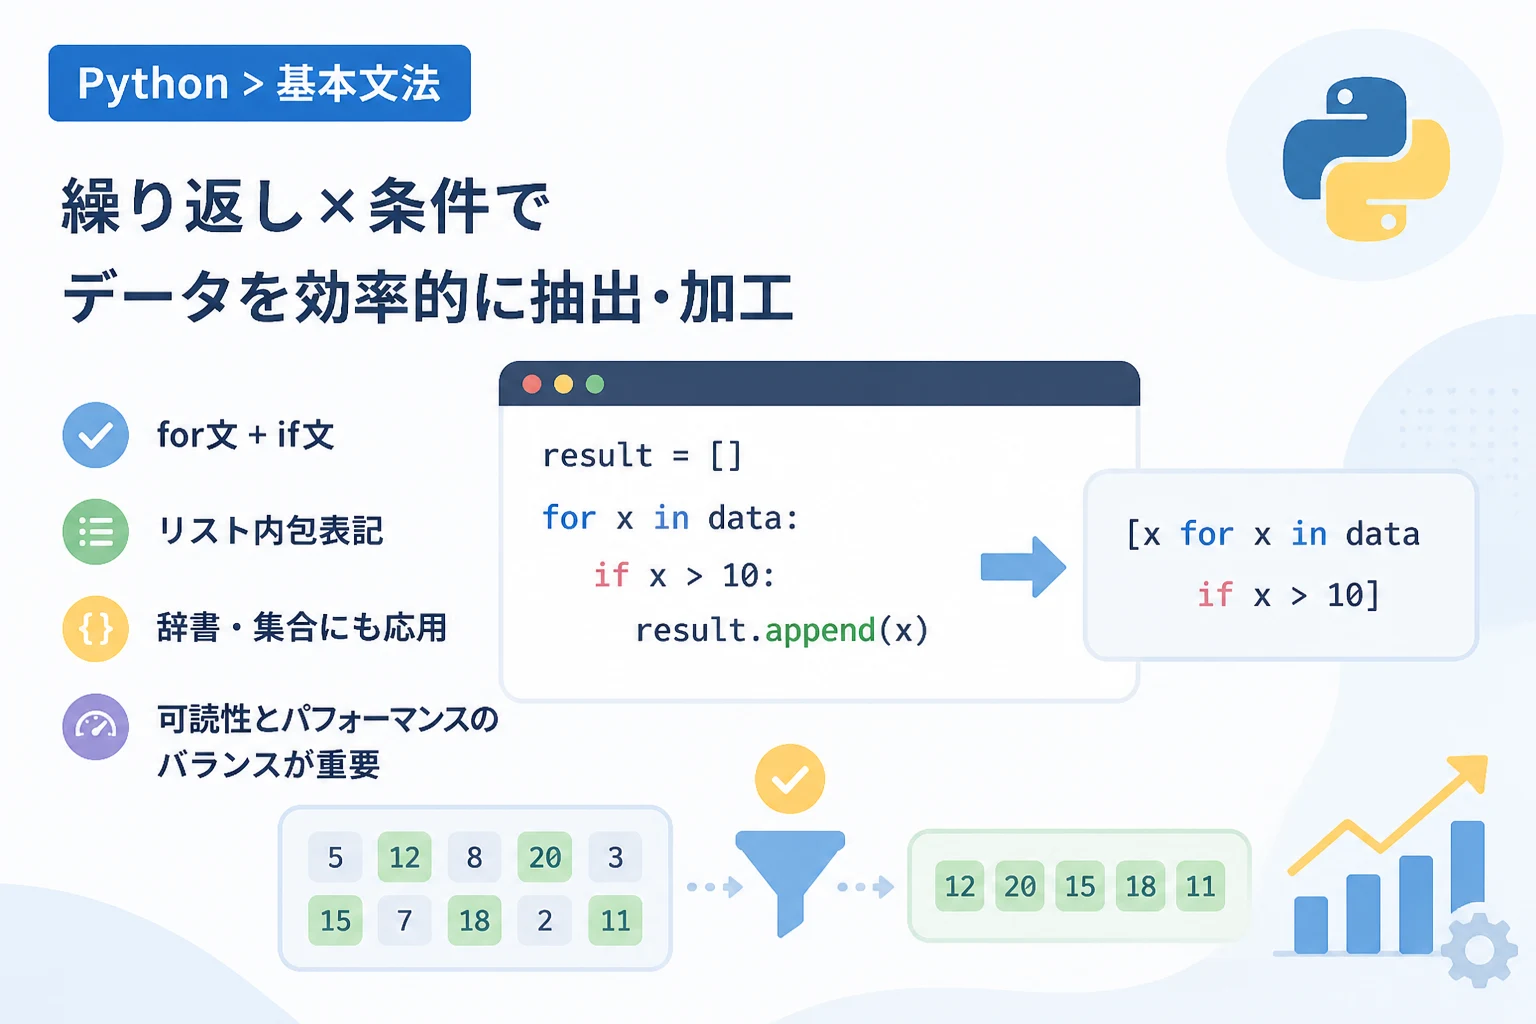
Pythonプログラミングにおいて、データの集まりから特定の条件に合致するものだけを抽出したり、加工したりする操作は、日常的な開発業務で最も頻繁に登場するタスクの一つです。
こうした処理を効率的に記述するために欠かせないのが、for文による繰り返し処理とif文による条件分岐の組み合わせです。
本記事では、初心者の方が最初に取り組むべき基本的なループ内の条件分岐から、Pythonらしい簡潔な記述を可能にする「リスト内包表記」、さらにはメモリ効率を意識したジェネレータ表現まで、実務で役立つ具体的な手法を詳しく解説します。
Pythonにおけるfor文とif文の基本構造
Pythonの繰り返し処理において、最も標準的な手法はforループの中でif文を使用する方法です。
この構造は可読性が高く、複雑なロジックを組み込む際に適しています。
基本的なフィルタリングの書き方
まずは、数値のリストから偶数だけを抽出して新しいリストを作成する例を見てみましょう。
# 数値のリストを定義
numbers = [1, 12, 7, 24, 35, 48, 51, 60]

# 偶数を入れるための空のリストを作成
even_numbers = []

# ループ処理を開始
for num in numbers:
    # 2で割り切れるかどうかの条件判定
    if num % 2 == 0:
        # 条件に合致する場合のみ、リストに追加
        even_numbers.append(num)

print(even_numbers)[12, 24, 48, 60]このコードでは、イテラブルオブジェクト(リストなど)の各要素に対してif文による判定を行い、条件を満たした場合のみ特定の処理(ここではappend)を実行しています。
continue文による効率化
特定の条件に合致しない場合に、その後の処理をスキップして次のループへ進みたい場合は、continue文を活用するのがスマートです。
これにより、ネスト(階層)が深くなるのを防ぐことができます。
data_list = ["Apple", None, "Orange", "", "Banana"]

# 有効な文字列のみを処理する
for item in data_list:
    # 値がNoneまたは空文字の場合はスキップ
    if item is None or item == "":
        continue

    # 正常なデータに対する処理
print(f"Processing: {item}")Processing: Apple
Processing: Orange
Processing: Bananaこのように、ガード節(不適切な条件を先に排除する手法)としてif文を使うことで、メインの処理をスッキリと記述できるようになります。
リスト内包表記による効率的な記述
Pythonには、「リスト内包表記 (List Comprehensions)」と呼ばれる強力な構文があります。
これを使うと、数行にわたるfor文とif文の組み合わせを、わずか1行で記述することが可能です。
基本的なフィルタリングの内包表記
先ほどの「偶数のみを抽出する」処理をリスト内包表記に書き換えると、以下のようになります。
numbers = [1, 12, 7, 24, 35, 48, 51, 60]

# 内包表記によるフィルタリング
even_numbers = [num for num in numbers if num % 2 == 0]

print(even_numbers)[12, 24, 48, 60]リスト内包表記の基本構成は、[式 for 変数 in イテラブル if 条件式]となります。
この書き方のメリットは、単にコードが短くなるだけでなく、Pythonの内部で最適化されているため、通常のfor文よりも高速に動作する傾向がある点にあります。
複数の条件を組み合わせる
if文を複数つなげることで、より複雑な条件を指定することもできます。
例えば、「30以上」かつ「偶数」である要素を抽出する場合を考えます。
numbers = [10, 25, 36, 42, 55, 68, 71]

# 複数の条件(30以上かつ偶数)を適用
filtered_list = [n for n in numbers if n >= 30 if n % 2 == 0]

print(filtered_list)[36, 42, 68]内包表記の中でifを並べて記述すると、それらは論理演算のandとして扱われます。
もちろん、if n >= 30 and n % 2 == 0と記述しても結果は同じです。
条件に応じた値の変更(if-else)
これまでは「条件に合うものだけを抽出する」方法を解説しましたが、「条件によって値を変換する」場合には、三項演算子(条件付き評価式)を組み合わせた内包表記を使用します。
if-elseを伴う内包表記の書き方
内包表記の中でelseを使いたい場合は、記述の順序が変わる点に注意が必要です。
| 目的 | 構文の書き方 |
|---|---|
| フィルタリング(抽出) | [x for x in list if 条件] |
| 値の出し分け(変換) | [値1 if 条件 else 値2 for x in list] |
具体的なコード例を見てみましょう。
scores = [45, 88, 62, 30, 95]

# 60点以上なら"Pass"、それ以外なら"Fail"に変換
results = ["Pass" if s >= 60 else "Fail" for s in scores]

print(results)['Fail', 'Pass', 'Pass', 'Fail', 'Pass']この構文では、if-else部分が「式」として評価されます。
そのため、リストの要素数は元のリストと変わりません。あくまで「各要素に対してどのような値を返すか」を決定する処理となります。
辞書や集合への応用
Pythonの便利な内包表記は、リスト以外にも適用可能です。
実務では辞書 (dict) のフィルタリングも非常によく使われます。
辞書内包表記でのフィルタリング
例えば、社員名と売上データが格納された辞書から、一定基準以上の売上を持つ社員だけを抽出する場合です。
sales_data = {
    "Tanaka": 150000,
    "Sato": 80000,
    "Suzuki": 200000,
    "Ito": 120000
}

# 売上が100,000円以上のデータのみ抽出
high_sales = {name: amount for name, amount in sales_data.items() if amount >= 100000}

print(high_sales){'Tanaka': 150000, 'Suzuki': 200000, 'Ito': 120000}items()メソッドでキーと値のペアを取得し、それに対して条件判定を行うことで、特定のデータのみを含んだ新しい辞書を素早く生成できます。
メモリ効率を重視する:ジェネレータ表現
扱うデータ量が非常に大きい(数百万件など)場合、リスト内包表記を使うとすべての結果をメモリ上に展開するため、メモリ不足に陥るリスクがあります。
そのような場面で活躍するのが「ジェネレータ表現」です。
ジェネレータ表現とリスト内包表記の違い
書き方はリスト内包表記の[]を()に変えるだけです。
import sys

# 1から1,000,000までの数値から偶数を抽出する場合
# リスト内包表記
list_comp = [n for n in range(1000000) if n % 2 == 0]

# ジェネレータ表現
gen_exp = (n for n in range(1000000) if n % 2 == 0)

print(f"List size: {sys.getsizeof(list_comp)} bytes")
print(f"Generator size: {sys.getsizeof(gen_exp)} bytes")
実行結果(環境により数値は異なります):
List size: 4167352 bytes
Generator size: 104 bytesジェネレータ表現は、「次の値を求められるまで計算を行わない」という遅延評価を行います。
そのため、大規模なログファイルの解析や、AIの学習データの前処理など、メモリ消費を抑えたい場面で非常に有効です。
実践的なユースケース:多重ループと条件分岐
ネストされたリスト(2次元配列など)から特定の条件でデータを抽出する際も、forとifを組み合わせて利用します。
# カテゴリごとの商品価格リスト
categories = [
    [1200, 2500, 800],
    [3500, 4200],
    [600, 1500, 2200]
]

# 全カテゴリの中で2000円以上の商品だけを一つのリストにまとめる
expensive_products = [
    price
    for category in categories
    for price in category
    if price >= 2000
]

print(expensive_products)[2500, 3500, 4200, 2200]このように多重ループを内包表記で書く際は、外側のループ、内側のループ、そしてif条件の順に記述します。
少し複雑に見えますが、慣れるとデータのフラット化(平坦化)とフィルタリングを同時に行える強力な武器になります。
どちらを使うべき?可読性とパフォーマンスのバランス
for文と内包表記のどちらを使うべきかは、状況によります。
通常のfor文を使うべきケース
- 処理内容が複雑で、数行にわたるロジックが必要な場合。
- ループの中で外部のファイルに書き出すなど、サイドエフェクト(副作用)がある場合。
- コードのデバッグを容易にしたい場合。
リスト内包表記を使うべきケース
- 単に既存のリストから新しいリストを作る「フィルタリング」や「マッピング」が目的の場合。
- 1行または2行程度で処理が完結し、一目で意図が伝わる場合。
- パフォーマンスが重視される処理の一部である場合。
Pythonの設計思想である「Zen of Python」には、
短く書けるからといって複雑すぎる内包表記を書くと、かえってメンテナンス性が低下する恐れがあるため注意しましょう。
まとめ
Pythonでfor文とif条件を組み合わせる方法は、プログラミングの基本でありながら、その書き方一つでコードの品質が大きく変わります。
- 基本的なfor + ifは可読性が高く、複雑なロジックに最適。
- リスト内包表記は簡潔かつ高速で、定型的なフィルタリングに強力。
- if-elseを組み合わせることで、データの変換も同時に行える。
- 大規模データの処理にはジェネレータ表現でメモリを節約する。
これらの手法を適切に使い分けることで、効率的で美しいPythonコードを書くことができるようになります。
まずは身近なリスト処理から、内包表記や条件付きループを取り入れてみてください。