
AI技術の進化により、多くの開発チームが短期間で魅力的なプロトタイプを作成できるようになりました。
Jupyter Notebook上でいくつかのプロンプトを試し、デモ用のエージェントがツールを呼び出す様子を見せれば、会議室には拍手が沸き起こるでしょう。
しかし、真の挑戦はその後に始まります。
「動くデモ」から「信頼できるサービス」への移行を阻むのは、予測不可能な本番トラフィック、ノイズの多い入力、厳格なSLA、コンプライアンス、そして膨れ上がるコストといった現実の壁です。
今日のAI開発において、「機能としてのAI」から「プラットフォームとしてのAI」への転換が求められています。
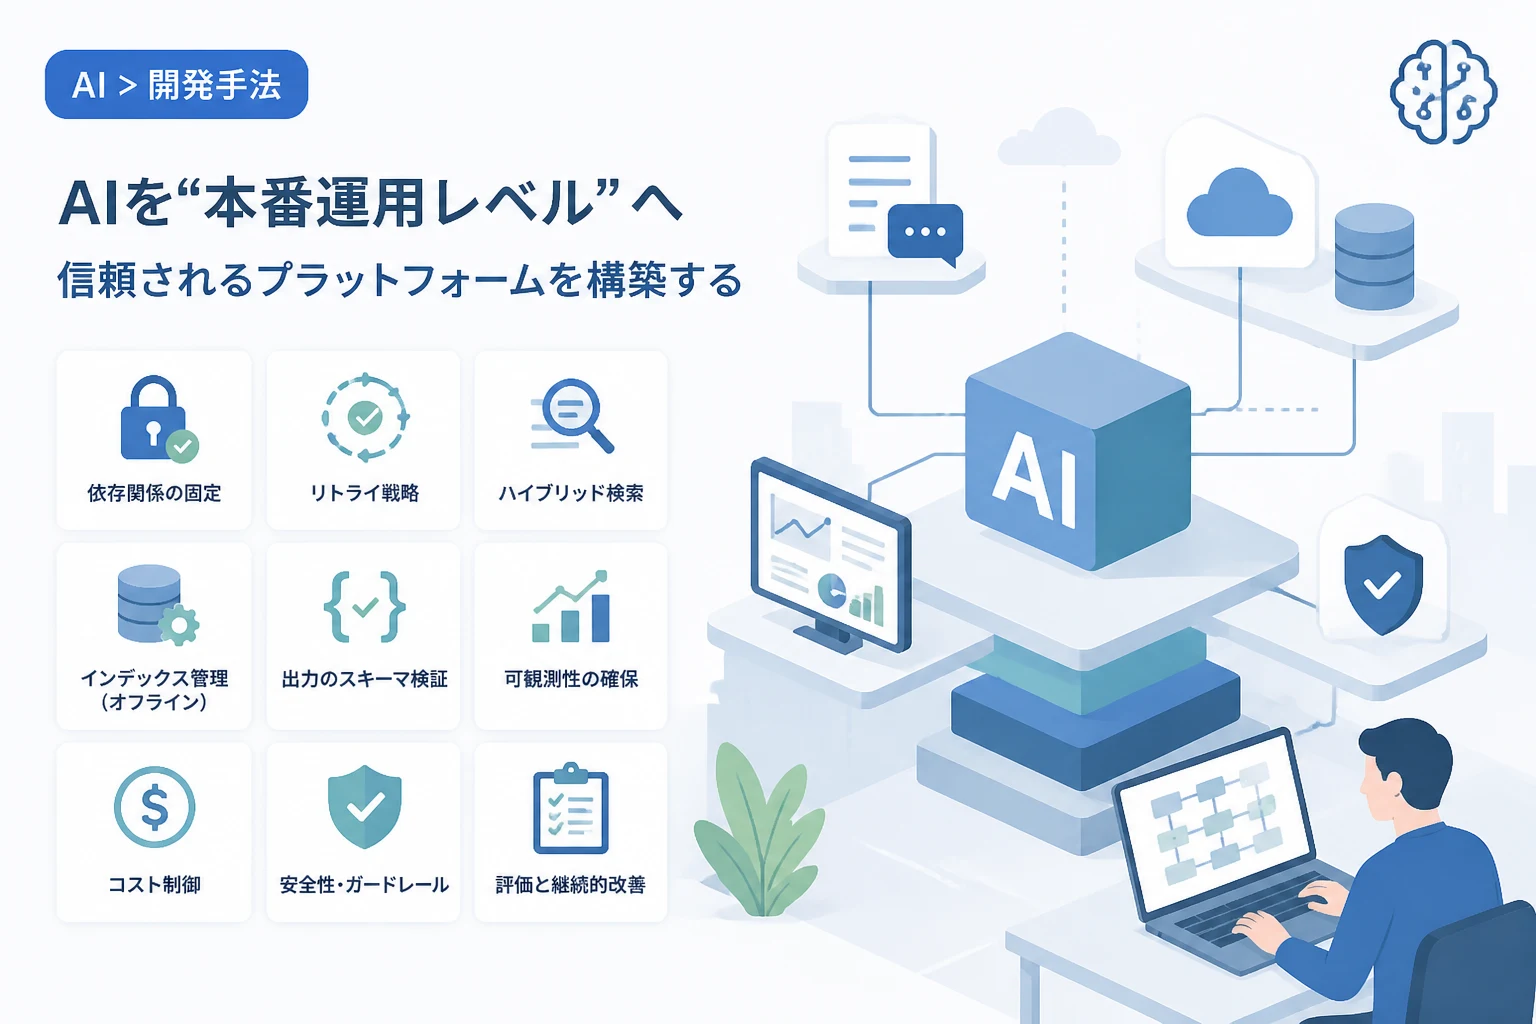
本記事では、デモレベルのAIを本番運用に耐えうる堅牢なシステムへと昇華させるために必要な「9つの鉄則」を、エンジニアリングの視点から深く掘り下げて解説します。
AIシステムにおけるプラットフォームエンジニアリングの重要性
現代のAIシステム開発は、かつてのマイクロサービスへの移行期に酷似しています。
単にモデルを呼び出すコードを書くのではなく、共有インフラストラクチャ、セキュリティ境界、可観測性、信頼性制御、そしてガバナンスを備えた実行モデルを構築しなければなりません。
多くの開発チームが陥る落とし穴は、AI特有の非決定性を過小評価し、従来のソフトウェア工学のベストプラクティスを疎かにすることにあります。
本番環境では、外部APIのレイテンシ、トークン消費によるコスト増、エージェントの無限ループといったリスクが常に存在します。
これらを管理するためには、AIを単なるスクリプトではなく、制御可能なインフラの一部として定義し直す必要があります。
鉄則1:依存関係の厳密な固定(Pinning)
プロトタイプ開発では最新のライブラリを随時インストールして試すのが一般的ですが、本番環境ではこれが最大の脆弱性になります。
特にLangChainやPydanticといった更新の激しいライブラリは、マイナーアップデートで破壊的変更が行われることが少なくありません。
「自分のマシンでは動いた」という問題を回避するために、requirements.txtやpoetry.lockを用いて、依存関係を完全に固定してください。
特にPydanticのバージョン1と2の混在や、LangChainのパッケージ分割は、依存関係のグラフを容易に崩壊させます。
| 対策項目 | 理由 | 推奨ツール |
|---|---|---|
| バージョン固定 | 予期せぬAPI変更によるランタイムエラーの防止 | Pipenv, Poetry, uv |
| 脆弱性スキャン | 依存ライブラリに含まれるセキュリティリスクの排除 | Snyk, GitHub Dependabot |
| 内部ミラーの利用 | 外部リポジトリのダウンタイムの影響を回避 | Artifactory, Cloud Artifact Registry |
鉄則2:リトライとタイムアウトを備えた堅牢なツール設計
AIエージェントが外部ツール(Web検索やAPI呼び出し)を使用する場合、その呼び出しは常に失敗する可能性があると考えるべきです。
ナイーブな実装では、外部サイトの応答遅延によりエージェント全体がハングアップし、リソースを無駄に消費し続けます。
ツールのインターフェースには、指数バックオフを用いたリトライ戦略と、厳格なタイムアウト設定を組み込んでください。
Pythonであればtenacityのようなライブラリを使用し、一時的なネットワークエラーを自動的に修復する仕組みが不可欠です。
また、HTMLパース時にはトークンコストを抑えるため、抽出するテキストの最大文字数を制限する(Truncation)処理も忘れてはなりません。
鉄則3:ハイブリッド検索によるRAGの最適化
検索拡張生成(RAG)において、ベクトル検索(埋め込み)だけに頼るのは危険です。
ベクトル検索は意味的な類似性には強いものの、製品番号や特定のキーワード、固有名詞といった「完全一致」を求める検索には不向きな場合があります。
本番環境のRAGでは、ベクトル検索とBM25(キーワード統計)を組み合わせたハイブリッド検索を採用すべきです。
さらに、検索結果の上位に対して「リランキング(再ランク付け)」を行うことで、コンテキストとしてLLMに渡す情報の精度を劇的に向上させることができます。
これにより、モデルが「根拠のない回答(ハルシネーション)」を生成するリスクを低減できます。
鉄則4:インデックス管理のデカップリング
アプリケーションの起動時に埋め込みベクトルを生成し、インデックスを再構築する構成は、プロトタイプ特有のアンチパターンです。
データ量が増えるにつれて起動時間が数分から数時間に延び、デプロイのボトルネックとなります。
インデックス作成のオフライン化
インデックスの構築は、アプリケーション本体のライフサイクルから切り離し、CI/CDパイプラインや定時ジョブとして実行してください。
- オフラインでドキュメントを処理し、ベクトル化を行う。
- FAISSなどのベクトルストアのインデックスをファイルまたはマネージドサービスとして保存する。
- アプリケーションは起動時に、構築済みのインデックスを
loadするだけで済むようにする。
この分離により、検索データの更新とアプリケーションのコード変更を独立して管理できるようになり、運用の柔軟性が高まります。
鉄則5:スキーマ検証とガードレールの導入
AIの出力は本質的に不安定です。
構造化されたデータ(JSONなど)を期待している場合、LLMがわずかに形式を崩すだけで後続のシステムがクラッシュします。
これを防ぐために、出力のスキーマ検証は必須です。
物理的な検証と論理的な検証
- 物理検証: Pydantic等を用い、データ型、必須フィールド、数値範囲をチェックする。
- 論理検証(ポリシーチェック): 個人情報(PII)の流出、機密情報(APIキーなど)、あるいは不適切な表現が含まれていないかを、正規表現や専用のフィルタリングツール(Guardrails)で検証する。
検証に失敗した場合は、ユーザーにそのまま返すのではなく、安全なエラーメッセージに差し替えるか、リトライを試みる「フェイルクローズ(Fail-closed)」の設計を徹底してください。
鉄則6:エージェントのループ制限とリソース管理
自律型エージェントは非常に強力ですが、目標を達成できない場合に「同じ失敗を延々と繰り返す」可能性があります。
これはAPIコストの急騰を招くだけでなく、システムリソースを枯渇させる要因となります。
本番環境で動作させるエージェントには、必ず以下の制約を設けてください。
max_iterations:最大ステップ数を制限し、無限ループを強制遮断する。request_timeout:LLMの応答待ち時間を制限する。- ウィンドウメモリの活用: 過去の会話履歴をすべて保持するのではなく、直近の数ターンのみを保持するように設定し、入力トークン量の肥大化を抑制する。
鉄則7:非同期処理とスレッドプールの適切な運用
FastAPIなどの非同期Webフレームワークを使用している場合、LangChainなどのブロッキングな処理(LLM呼び出しやCPU集約型タスク)を直接awaitなしで呼び出すと、イベントループがブロッキングされ、サーバー全体のパフォーマンスが低下します。
AIの推論処理は、run_in_threadpoolなどを使用して専用のスレッドプールにオフロードしてください。
これにより、長時間かかるAIの応答待ちの間も、サーバーは他のリクエストを処理し続けることができます。
並行性の確保は、スケーラビリティを確保する上での基本中の基本です。
鉄則8:OpenTelemetryによる「確かな」可観測性
ログをファイルに出力するだけでは、複雑なAIシステムの挙動を把握することは不可能です。
モデルの応答、ツールの呼び出し時間、トークン消費量、そしてコストを横断的に追跡する必要があります。
OpenTelemetryを導入し、分散トレーシングを実現してください。
- トレース: APIリクエストからエージェントの思考プロセス、最終回答までの流れを視覚化する。
- メトリクス: P99レイテンシ、エラー率、モデルごとのトークン使用量を計測する。
- スパン: どのステップ(検索、生成、ツール実行)で時間がかかっているかを特定する。
「なんとなく動いている」という感覚(Vibes)ではなく、定量的なデータに基づいたデバッグと最適化が行える環境を整えることが、プロフェッショナルな運用への第一歩です。
鉄則9:コスト制御とクォータ管理
AIプラットフォームの運用において、コストはエンジニアリング上の重要指標です。
無制限にリソースを解放すれば、単一のユーザーやバグのあるコードが月間予算を数日で使い果たすリスクがあります。
具体的なコスト対策
- トークン予算の設定: リクエストあたりの最大トークン数を制限する。
- キャッシング: 同一または類似の質問に対しては、セマンティックキャッシュを活用してモデルの呼び出しを削減する。
- モデルの階層化: 高度な推論が必要なタスクには高性能な大規模モデル(GPT-4oなど)を使い、単純な抽出や要約には安価な小規模モデルを使い分けるルーティングロジックを実装する。
| 手法 | メリット | 注意点 |
|---|---|---|
| セマンティックキャッシュ | コスト削減、応答の高速化 | キャッシュの鮮度管理が必要 |
| トークン制限 | 予算の予測可能性向上 | 回答が途切れる可能性がある |
| モデルルーティング | 費用対効果の最適化 | 分岐ロジックの複雑化 |
まとめ
プロトタイプから本番プラットフォームへの脱却は、決して魔法のような新モデルを導入することではありません。
それは、不確実なAIの挙動を、既存の堅実なソフトウェアエンジニアリングの枠組みで制御するプロセスそのものです。
本記事で紹介した9つの鉄則——依存関係の固定、リトライ戦略、ハイブリッド検索、インデックス管理の分離、ガードレールの設置、ループ制限、非同期並行処理、可観測性の確保、そしてコスト制御。
これらを一つずつ実装していくことで、あなたのAIシステムは、デモルームでの拍手を超え、実際のビジネス現場で数万件のトラフィックに耐えうる「真のプラットフォーム」へと進化するはずです。
エンジニアリングの基本に立ち返り、細部に宿る「本番のリアリティ」に真摯に向き合うこと。
それこそが、AI時代に求められる開発者の資質です。