
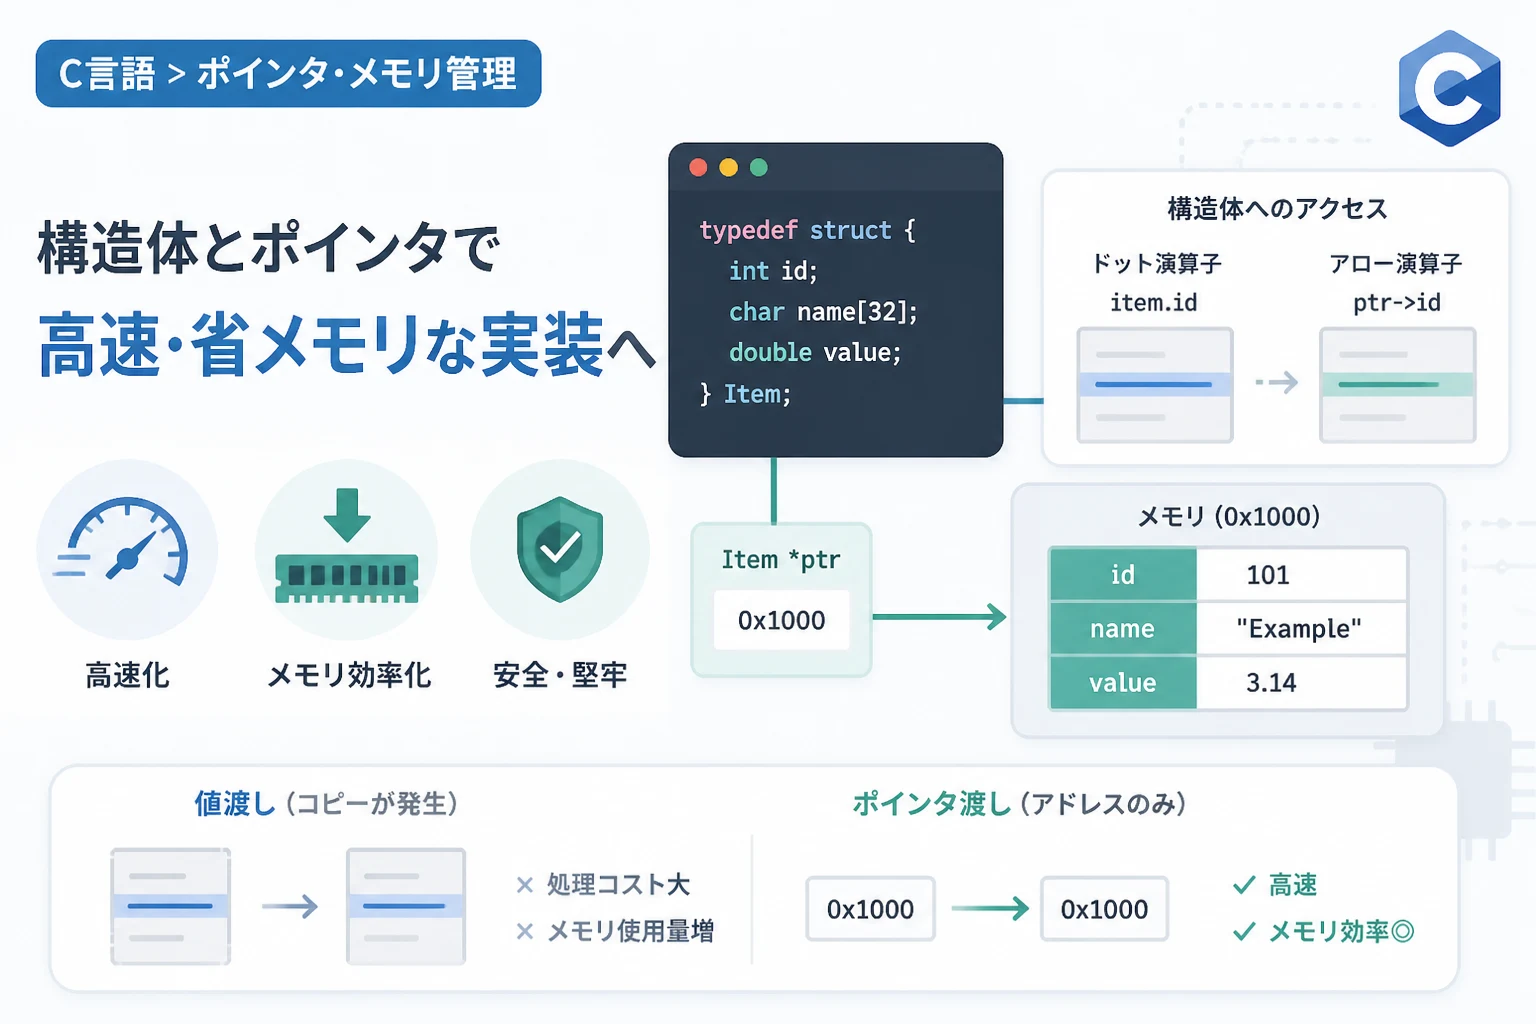
C言語を用いたシステム開発や組み込みソフトウェアの設計において、データの集合体である構造体と、メモリのアドレスを直接操作するポインタの組み合わせは、避けて通ることのできない極めて重要な技術要素です。
これらを正しく理解し使いこなすことは、プログラムの実行速度の向上やメモリ使用量の最適化に直結します。
本記事では、初心者から中級者へのステップアップを目指すエンジニアに向けて、構造体ポインタの基本概念からアロー演算子の具体的な活用方法、そして実務で求められるメモリ効率を高めるための実装テクニックまでを論理的に詳しく解説していきます。
構造体ポインタが必要とされる背景
C言語の構造体は、異なる型を持つ複数の変数を一つの単位として扱うための強力なツールです。
しかし、構造体そのものを関数の引数として渡したり、戻り値として受け取ったりする場合、値のコピーが発生するため、構造体のサイズが大きくなればなるほどパフォーマンスに悪影響を及ぼします。
ここで重要になるのが「ポインタ」です。
構造体そのものではなく、構造体が格納されているメモリ上のアドレスだけをやり取りすることで、データのコピーを最小限に抑え、処理を高速化することが可能になります。
現代のコンピューティング環境においても、リソースが限られた組み込み環境や、膨大なデータを処理するバックエンドシステムでは、この手法が不可欠です。
構造体ポインタの定義と初期化
構造体のポインタを扱う第一歩は、正しい宣言と初期化の方法を理解することです。
通常の構造体変数とポインタ変数の宣言を比較しながら見ていきましょう。
構造体ポインタの基本的な書き方
まずは、構造体の型を定義し、そのポインタを宣言する基本的なコード例を示します。
#include <stdio.h>
#include <string.h>

// 構造体の定義
struct MyDevice {
    int id;
    char name[32];
    double version;
};

int main() {
    // 構造体変数の実体を宣言
    struct MyDevice sensor;

    // 構造体ポインタの宣言と初期化
    // 演算子 & を使用してアドレスを取得する
    struct MyDevice *ptr = &sensor;

    // データの代入
    sensor.id = 101;
    strcpy(sensor.name, "Thermal Sensor");
    sensor.version = 2.5;

    // ポインタを介して値を表示
    printf("Device ID: %d\n", ptr->id);
    printf("Device Name: %s\n", ptr->name);
    printf("Version: %.1f\n", ptr->version);

    return 0;
}Device ID: 101
Device Name: Thermal Sensor
Version: 2.5この例では、struct MyDevice *ptr という形式でポインタを定義しています。
ポインタ変数 ptr には、実体である sensor のアドレスが格納されています。
ここで登場した -> という記号が、構造体ポインタを扱う上で欠かせない「アロー演算子」です。
アロー演算子の仕組みとメリット
アロー演算子(->)は、ポインタを経由して構造体のメンバにアクセスするための専用演算子です。
なぜドット演算子(.)ではなくアロー演算子が必要なのか、その内部的な挙動を確認してみましょう。
ドット演算子との違い
もしアロー演算子を使わずに、ポインタ経由でメンバにアクセスしようとすると、次のような記述が必要になります。
// ドット演算子を使う場合の冗長な書き方
(*ptr).id = 202;ここで、(*ptr) をカッコで囲んでいるのは、ポインタの関節参照演算子(*)よりもドット演算子(.)の方が優先順位が高いためです。
カッコを忘れると、コンパイラはポインタのアドレスそのものに対してドット演算子を適用しようとし、エラーが発生します。
このような煩雑な記述を簡略化し、可読性を高めるために導入されたのがアロー演算子です。
ptr->id と記述するだけで、「ポインタ ptr が指し示す先にある構造体のメンバ id」へ直感的にアクセスできます。
アロー演算子のメリット
- コードの簡潔化: カッコとアスタリスクを多用する必要がなくなり、タイピングミスを減らせます。
- 直感的な理解: 「ポインタがその方向を指している」という視覚的なイメージが、プログラムの論理構造と一致します。
- 一貫性: 構造体をポインタで管理することが一般的な大規模開発において、記述スタイルを統一できます。
メモリ効率を高める実装手法
構造体とポインタを組み合わせる最大の動機の一つは、メモリ効率と実行速度の最適化にあります。
ここでは、実務で多用されるテクニックをいくつか紹介します。
関数の引数に構造体ポインタを渡す
構造体全体を値渡し(Call by Value)すると、スタック領域に構造体の全データがコピーされます。
例えば、1KBの構造体を1000回関数に渡すと、それだけで膨大なメモリコピーが発生し、CPUリソースを浪費します。
一方、ポインタ渡し(実際にはアドレスの値渡し)であれば、渡されるデータはアドレスのサイズ(一般的に8バイト程度)のみであり、劇的に負荷を軽減できます。
#include <stdio.h>

struct HugeData {
    int data[1000]; // 大きなデータを持つ構造体
    int status;
};

// ポインタ経由で受け取ることでコピーを防ぐ
// 内容を変更しない場合は const を付けるのが推奨される
void processData(const struct HugeData *ptr) {
    printf("Status: %d\n", ptr->status);
    // ptr->status = 1; // const があるため変更不可。安全性が高い
}

int main() {
    struct HugeData myData = { .status = 42 };

    // ポインタ(アドレス)を渡す
    processData(&myData);

    return 0;
}このように、関数引数として構造体ポインタを利用する手法は、大規模開発における標準的なプラクティスとなっています。
構造体のアライメントとパディング
メモリ効率を語る上で欠かせないのが「アライメント」です。
CPUは特定のバイト境界(4バイトや8バイトなど)に合わせてメモリにアクセスするのが最も効率的であるため、コンパイラは構造体のメンバ間に見えない「詰め物(パディング)」を挿入することがあります。
struct Sample {
    char a;      // 1バイト
    // 3バイトのパディングが発生する可能性がある
    int b;       // 4バイト
    char c;      // 1バイト
    // 3バイトのパディングが発生する可能性がある
};
この構造体は、論理的には計6バイトですが、実際には12バイト(またはそれ以上)を消費することがあります。
ポインタを使用してメモリを効率的に管理するためには、大きなサイズの型から順にメンバを並べることでパディングを最小化し、メモリ使用量を抑える設計が推奨されます。
動的メモリ確保と構造体ポインタの高度な連携
プログラムの実行中に必要なデータの数が変わる場合、静的な配列ではなく、malloc 関数を用いた動的メモリ確保を利用します。
この際、構造体ポインタは必須の存在となります。
mallocによる構造体の生成
以下のコードは、実行時に構造体のメモリを確保し、不要になったら解放する一連の流れを示しています。
#include <stdio.h>
#include <stdlib.h>

struct User {
    int id;
    char role[16];
};

int main() {
    // 構造体のサイズ分だけメモリを動的に確保
    struct User *userPtr = (struct User *)malloc(sizeof(struct User));

    // メモリ確保に失敗していないか確認
    if (userPtr == NULL) {
        fprintf(stderr, "Memory allocation failed.\n");
        return 1;
    }

    // アロー演算子で値をセット
    userPtr->id = 777;
    snprintf(userPtr->role, sizeof(userPtr->role), "Admin");

    printf("User ID: %d, Role: %s\n", userPtr->id, userPtr->role);

    // 確保したメモリを必ず解放する
    free(userPtr);
    // 安全のためポインタをNULLで初期化
    userPtr = NULL;

    return 0;
}User ID: 777, Role: Admin動的メモリ確保を使用する場合、free関数によるメモリの解放を忘れると「メモリリーク」の原因となるため注意が必要です。
また、C23以降の規格を使用している場合は、NULL の代わりに nullptr を使用することで、型安全性を高めることができます。
構造体配列の動的な管理
構造体ポインタをさらに応用すると、構造体の配列を動的に作成できます。
これは、データベースのレコード管理や、ゲームにおけるオブジェクト管理などで非常に有効です。
int numElements = 5;
struct User *userList = (struct User *)malloc(sizeof(struct User) * numElements);

for (int i = 0; i < numElements; i++) {
    userList[i].id = i + 1; // 配列形式でのアクセス(実体として扱う)
    // あるいはポインタ演算を使って
    // (userList + i)->id = i + 1;
}このように、userList[i].id と書くか、(userList + i)->id と書くかは、文脈やチームの規約によりますが、アロー演算子を用いる後者の方が「ポインタ演算を行っている」ことを明示的に示すことができます。
実装上の注意点とデバッグのコツ
構造体ポインタは強力ですが、一歩間違えるとシステムクラッシュを招く「セグメンテーション違反」の原因になります。
安全なコードを書くためのポイントを整理しましょう。
NULLチェックの徹底
ポインタを使用する前には、必ずそのポインタが有効なメモリを指しているかを確認する必要があります。
特に、関数の引数として受け取ったポインタが NULL ではないことをチェックするのは、堅牢なプログラムを作成する上での基本です。
void updateVersion(struct MyDevice *dev) {
    if (dev == NULL) {
        return; // エラーハンドリング
    }
    dev->version += 0.1;
}
自己参照構造体とポインタ
リスト構造(Linked List)や木構造(Tree)を実装する場合、構造体の中に自分自身の型を指すポインタを含めます。
これはポインタを介してのみ実現可能な手法です。
struct Node {
    int data;
    struct Node *next; // 次の要素へのポインタ
};
このように、ポインタを駆使することで、固定長ではない柔軟なデータ構造を構築できるようになります。
メモリ効率の観点からも、必要な時に必要な分だけノードを追加できるリスト構造は、非常に効率的です。
パフォーマンス最適化のためのテクニック
構造体ポインタを活用したさらなる最適化として、以下の2点を意識すると良いでしょう。
1. キャッシュ効率の考慮
CPUキャッシュは、連続したメモリ領域へのアクセスを得意とします。
構造体ポインタの配列を作るよりも、構造体の大きな配列を作り、その要素へのポインタを適宜受け渡す方が、空間局所性(Spatial Locality)が高まり、パフォーマンスが向上する傾向にあります。
2. インライン化とポインタ
小規模なアクセス関数に構造体ポインタを渡す場合、inline キーワードを活用することで、関数呼び出しのオーバーヘッドを消しつつ、ポインタによる柔軟な設計を維持できます。
| 手法 | メリット | デメリット |
|---|---|---|
| 値渡し | データの独立性が高い(元のデータが壊れない) | コピーコストが大きい、メモリを消費する |
| ポインタ渡し | メモリ効率が良い、高速に動作する | 元のデータが書き換わるリスク、NULLチェックが必要 |
構造体ポインタの応用:関数ポインタの保持
最後に、構造体の中に「関数ポインタ」をメンバとして持たせる手法についても触れておきます。
これにより、C言語であってもオブジェクト指向のような「メソッド」の概念を擬似的に実現できます。
#include <stdio.h>

struct Calculator {
    int (*operation)(int, int);
};

int add(int a, int b) { return a + b; }
int multiply(int a, int b) { return a * b; }

int main() {
    struct Calculator calc;
    struct Calculator *pCalc = &calc;

    pCalc->operation = add;
    printf("Result: %d\n", pCalc->operation(10, 5));

    pCalc->operation = multiply;
    printf("Result: %d\n", pCalc->operation(10, 5));

    return 0;
}
このように、アロー演算子を介して「関数を実行する」という実装は、ドライバ開発やプラグインシステムにおいて非常に一般的です。
まとめ
C言語における構造体ポインタとアロー演算子の活用は、単なるコードの書き方の問題ではなく、ハードウェアの性能を最大限に引き出し、保守性の高いプログラムを記述するための必須スキルです。
本記事で解説した以下のポイントを心に留めておいてください。
- アロー演算子(
->)は、ポインタ経由でメンバにアクセスするための直感的かつ簡潔な手段である。 - 関数の引数に構造体ポインタを使用することで、不必要なメモリコピーを排除し、パフォーマンスを大幅に向上させることができる。
- 動的メモリ確保(
malloc/free)を組み合わせることで、柔軟で効率的なデータ管理が可能になる。 - アライメントやパディング、NULLチェックといった詳細な部分に注意を払うことで、堅牢なシステムを構築できる。
これらの知識を土台として、より複雑なデータ構造や大規模なシステム開発に挑戦していきましょう。
ポインタを制する者は、C言語における真の制御力を手にすることができます。