
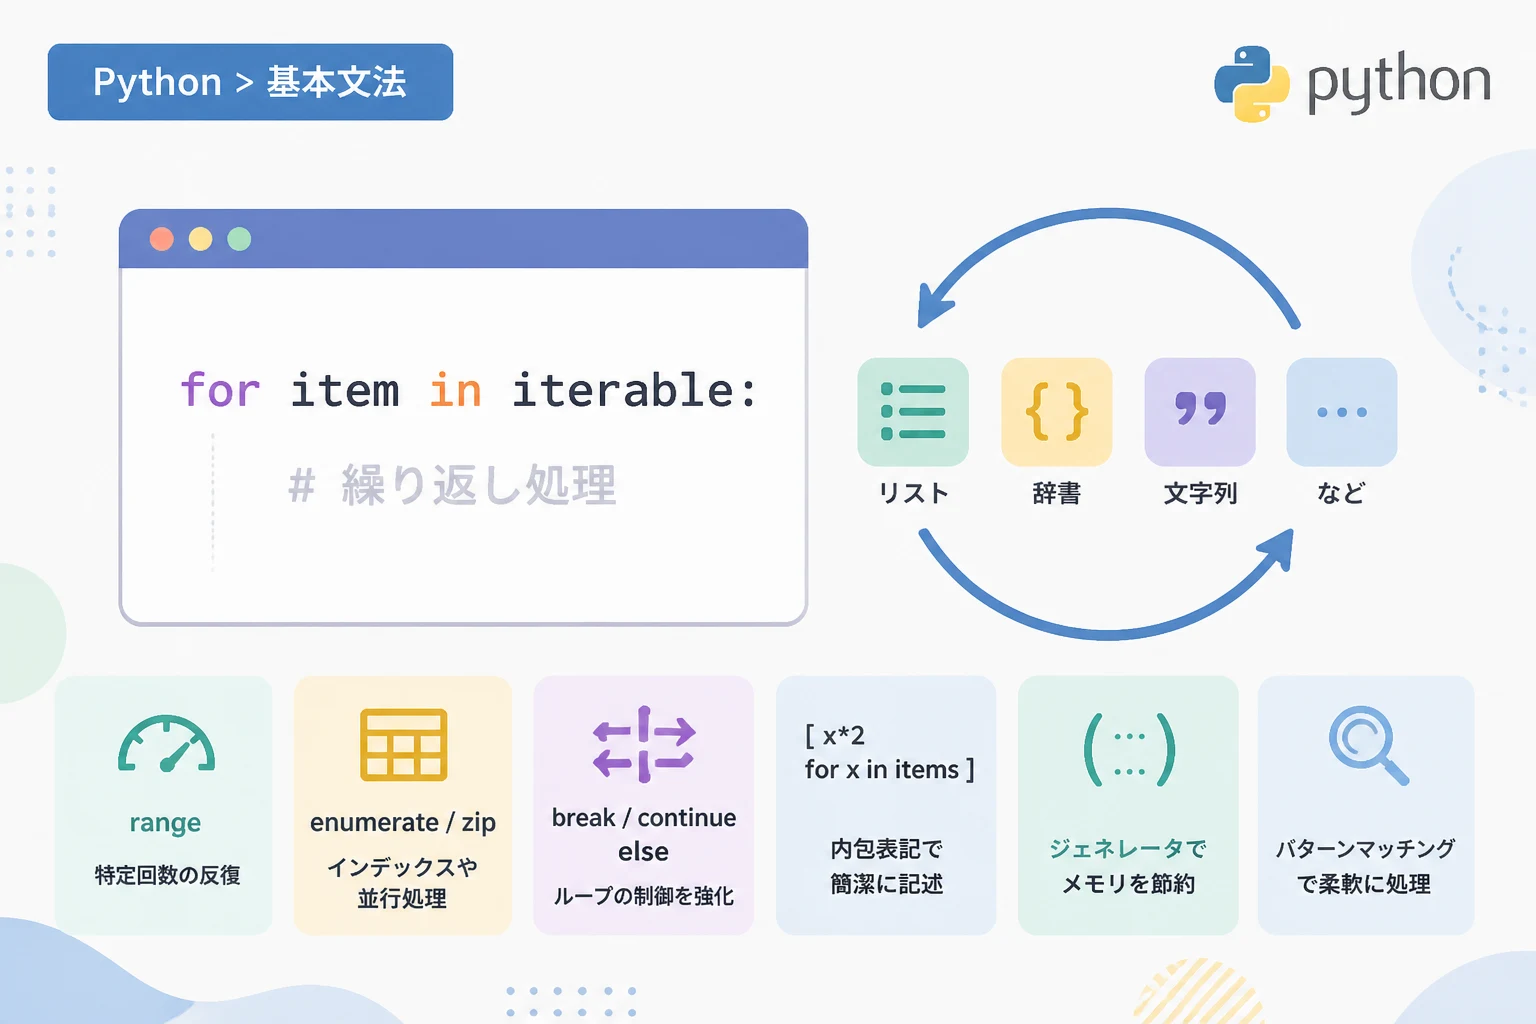
Pythonにおいて、プログラムの制御フローを司る最も重要な構文の一つがfor in文です。
データの集合体であるリストや辞書、あるいは特定の回数だけ処理を繰り返すなど、その用途は多岐にわたります。
Pythonのfor文は、他言語で見られるカウンタ変数を用いた形式とは異なり、イテラブル(反復可能)なオブジェクトから要素を一つずつ取り出す「フォーイーチ(for-each)」型のスタイルを採用しているのが特徴です。
この記事では、初心者向けの基礎知識から、実務で役立つモダンで効率的な記述法、さらには内部的な仕組みまでを詳しく解説します。
for in文の基本構造と動作原理
Pythonのfor in文は、指定したオブジェクトから要素を順番に取り出し、それらをループ内で処理するために使用されます。
もっともシンプルな構文は以下の通りです。
# リスト内の要素を順番に表示する基本の形
fruits = ["apple", "banana", "cherry"]

for fruit in fruits:
    # 取得した要素(fruit)を処理する
print(f"I like {fruit}")I like apple
I like banana
I like cherryこのコードでは、fruitsというリストの中身が一つずつ変数fruitに代入され、リストの末尾に達するまで処理が繰り返されます。
イテラブル(Iterable)とは何か
for in文のinの後に指定できるオブジェクトをイテラブルと呼びます。
イテラブルとは、要素を一つずつ取り出す仕組み(イテレータ)を提供できるオブジェクトのことです。
Pythonの主要なデータ型であるリスト、タプル、セット、辞書、そして文字列もすべてイテラブルに含まれます。
例えば、文字列をfor in文に渡すと、一文字ずつ処理が行われます。
# 文字列を一文字ずつ取り出す
message = "Python"

for char in message:
print(char.upper())P
Y
T
H
O
Nrange関数を活用した数値による反復
特定の回数だけ処理を繰り返したい場合や、連続する数値を使用したい場合にはrange()関数を併用するのが一般的です。
range()はメモリ効率が非常に良く、大規模なループ処理でもパフォーマンスを維持できるように設計されています。
range関数の基本的な使い方
range(stop)、range(start, stop)、range(start, stop, step)の3種類の引数の取り方があります。
# 0から4まで(5回)繰り返す
print("--- case 1 ---")
for i in range(5):
    print(i)

# 2から7未満まで繰り返す
print("--- case 2 ---")
for i in range(2, 7):
    print(i)

# 1から10までを2刻み(奇数)で取得する
print("--- case 3 ---")
for i in range(1, 11, 2):
print(i)--- case 1 ---
0
1
2
3
4
--- case 2 ---
2
3
4
5
6
--- case 3 ---
1
3
5
7
9注意点として、終了値(stop)として指定した数値そのものは含まれないというルールを覚えておきましょう。
これはPythonのインデックス(添字)が0から始まる仕様と親和性を高くするための設計です。
辞書データの効率的なループ処理
辞書(dict)はキーと値のペアを持つデータ構造ですが、for in文の書き方によって「キーだけ」「値だけ」「両方」を自在に取得できます。
keys, values, itemsの使い分け
デフォルトの動作ではキーが取得されますが、.items()メソッドを使用することでアンパック(複数変数への代入)を利用したスマートな記述が可能です。
| メソッド | 取得できる内容 | 用途 |
|---|---|---|
for k in d: | キー | キーのみが必要な場合 |
for v in d.values(): | 値 | 値だけを計算や出力に使いたい場合 |
for k, v in d.items(): | キーと値のペア | 両方のデータを同時に扱いたい場合 |
user_scores = {"Alice": 85, "Bob": 92, "Charlie": 78}

# 名前(キー)とスコア(値)を同時に取り出す
for name, score in user_scores.items():
print(f"{name}'s score is {score}")Alice's score is 85
Bob's score is 92
Charlie's score is 78インデックスと要素を同時に取得するenumerate関数
リストの処理中に「今、何番目の要素を処理しているか」というインデックス番号が必要になる場面は多いでしょう。
C言語やJavaのようなカウンタ変数を手動で増やす(i += 1)方法は、Pythonでは非推奨(アンチパターン)とされています。
代わりにenumerate()を使用します。
colors = ["red", "green", "blue"]

# enumerateを使うことでインデックスと要素を安全に取得できる
for index, color in enumerate(colors, start=1):
print(f"No.{index}: {color}")No.1: red
No.2: green
No.3: bluestart=1という引数を渡すことで、インデックスの開始番号を1から(あるいは任意の数値から)始めることができます。
これにより、表示用の番号を計算する手間が省けます。
複数のイテラブルを並行して回すzip関数
「2つのリストの同じ位置にある要素同士を組み合わせて処理したい」という場合には、zip()関数が威力を発揮します。
names = ["Taro", "Jiro", "Saburo"]
ages = [20, 18, 15]

# 2つのリストを同時にループ
for name, age in zip(names, ages):
print(f"{name} is {age} years old.")Taro is 20 years old.
Jiro is 18 years old.
Saburo is 15 years old.なお、複数のリストの長さが異なる場合、zip()はもっとも短いリストに合わせて停止します。
長い方に合わせたい場合は、標準ライブラリのitertools.zip_longestを使用します。
ループの制御:break, continue, else
ループの途中で処理を中断したり、特定の条件でスキップしたりするための制御構文についても理解を深めましょう。
breakとcontinue
- break: ループ全体を強制終了します。
- continue: 現在の回の処理を中断し、次のループ(次の要素)へ進みます。
numbers = [1, 2, 10, 4, 5]

for n in numbers:
    if n > 5:
        print(f"Found large number: {n}. Stopping loop.")
        break
print(f"Processing: {n}")Processing: 1
Processing: 2
Found large number: 10. Stopping loop.意外と知らないfor-else構文
Pythonのfor文にはelse節を付けることができます。
これは「ループがbreakされずに最後まで正常に完了したときだけ実行される」という特殊な動きをします。
target = 7
data = [1, 3, 5, 9]

for item in data:
    if item == target:
        print("Found it!")
        break
else:
    # ループ内でbreakが発生しなかった(見つからなかった)場合に実行される
print("Not found...")Not found...検索処理などで「見つからなかった場合のフラグ管理」を不要にする、非常にモダンでクリーンな記述法です。
リスト内包表記:モダンなPythonistaの選択
Pythonのfor in文をより簡潔に記述する方法として、リスト内包表記があります。
新しいリストを生成する場合、通常のfor文よりも高速であり、コードも一行で完結します。
# 通常のfor文
squares = []
for i in range(1, 6):
    squares.append(i * i)

# リスト内包表記
squares_modern = [i * i for i in range(1, 6)]

print(squares_modern)[1, 4, 9, 16, 25]条件付き内包表記
内包表記の中にはif文を組み込むことも可能です。
# 10以下の数値から偶数だけを取り出し、2倍にする
even_doubled = [n * 2 for n in range(11) if n % 2 == 0]
print(even_doubled)[0, 4, 8, 12, 16, 20]このように、データのフィルタリングと変換を同時に行えるのが内包表記の強みです。
ただし、あまりに複雑な条件を一行に詰め込むと可読性が低下するため、目安として2行以上のロジックになる場合は通常のfor文を検討しましょう。
イテレータとジェネレータ:内部メカニズムへの理解
Pythonのfor in文がなぜこれほど柔軟なのか、その理由はイテレータプロトコルにあります。
イテレータの仕組み
for文が実行されるとき、Python内部ではまず対象のオブジェクトからイテレータを取得(__iter__()の呼び出し)し、その後、要素がなくなるまでnext()関数を繰り返し呼び出しています。
# for文の内部動作を擬似的に再現
my_list = [10, 20]
iterator = iter(my_list)

print(next(iterator)) # 10
print(next(iterator)) # 20
# print(next(iterator)) # これ以上要素がないと StopIteration 例外が発生する
ジェネレータによるメモリ節約
大規模なデータを扱う際、リストにすべての要素を格納するとメモリを圧迫します。
そこで、ジェネレータ(Generator)を使用します。
ジェネレータは「必要なときに必要な分だけ」要素を生成するため、省メモリで高速です。
# ジェネレータ式の例(丸括弧を使用)
large_data_gen = (i**2 for i in range(1000000))

# 最初の3つだけ取得
for _ in range(3):
print(next(large_data_gen))0
1
4Python 3.10以降の最新機能とイテレーション
近年のPythonアップデートでも、繰り返し処理に関連する便利な機能が追加されています。
pattern matching(Python 3.10〜)
match-case文をfor文の中で使うことで、複雑な構造のデータ処理が劇的に簡潔になります。
commands = [("move", 10), ("wait", 5), ("stop",)]

for cmd in commands:
    match cmd:
        case ("move", distance):
            print(f"Moving {distance}m")
        case ("wait", duration):
            print(f"Waiting for {duration}s")
        case ("stop",):
print("Stopping system")Moving 10m
Waiting for 5s
Stopping systemこのように、タプルの要素数や内容に応じた条件分岐を直感的に記述できます。
実践的なTipsとベストプラクティス
Pythonでfor in文を書く際に、より高品質なコードにするためのポイントをまとめます。
1. 二重ループ(入れ子)を避ける工夫
多重ループは計算量が爆発的に増える原因となります。
デカルト積(すべての組み合わせ)を求めたい場合は、itertools.productを使うとインデントが深くならず、スッキリと記述できます。
import itertools

colors = ["red", "blue"]
sizes = ["S", "M", "L"]

# 二重ループの代わりにproductを使用
for color, size in itertools.product(colors, sizes):
    print(f"{color} - {size}")
2. ループ内でのリスト操作に注意
ループの対象にしているリストに対して、ループ内でremove()やappend()を行うと、インデックスがズレて予期せぬ挙動(スキップや無限ループ)を招くことがあります。
要素を削除したい場合は、逆順で回すか、内包表記で新しいリストを作るのが安全です。
3. 大きなデータの読み込みは1行ずつ
ファイル操作において、readlines()ですべての行をメモリに読み込むのではなく、ファイルオブジェクトそのものをfor文に渡すことで、1行ずつメモリを節約しながら処理できます。
# 推奨されるファイル処理の書き方
with open("large_log.txt", "r") as f:
    for line in f:
        if "ERROR" in line:
            print(line.strip())
まとめ
Pythonのfor in文は、単なる繰り返しのための道具ではなく、データの流れを美しく、かつ効率的に制御するための強力なインターフェースです。
- 基本的なリストや辞書の反復から始め、enumerateやzipなどの組み込み関数を使いこなすことで、コードの可読性は飛躍的に向上します。
- メモリ効率を意識するならジェネレータやrangeの性質を理解することが重要です。
- さらにリスト内包表記やパターンマッチングといったモダンな記述を取り入れることで、Pythonらしい簡潔なプログラムが書けるようになります。
繰り返し処理はプログラミングの基本ですが、その奥は深く、マスターすることでエンジニアとしての生産性は大きく変わります。
この記事で紹介したテクニックを、ぜひ日々の開発に取り入れてみてください。